[学习笔记] - 非线性规划

最优化问题

最优化问题的数学模型一般形式为

minf0(x)s.t.fi(x)=0,i=1,⋯ ,mfi(x)≥0i=m+1,⋯ ,p\begin{aligned} min &\qquad f_0(\mathbf{x}) & \\ s.t. &\qquad f_i(\mathbf{x}) = 0, &i = 1, \cdots, m \\ &\qquad f_i(\mathbf{x}) \geq 0 &i = m + 1, \cdots, p \end{aligned}


无约束最优化问题:无任何约束的最优化问题

minf(x),x∈Rn\begin{aligned} min &\qquad f(\mathbf{x}),\quad \mathbf{x} \in \mathbb{R}^n \end{aligned}

约束最优化问题:只要问题中存在任何约束条件,就称为约束最优化问题
等式约束问题:只有等式的约束的情况

minf(x)s.t.fi(x)=0,i=1,⋯ ,m\begin{aligned} min &\qquad f(\mathbf{x}) & \\ s.t. &\qquad f_i(\mathbf{x}) = 0, &i = 1, \cdots, m \end{aligned}

不等式约束问题:只有不等式的约束的情况

minf(x)s.t.fi(x)≥0,i=1,⋯ ,m\begin{aligned} min &\qquad f(\mathbf{x}) & \\ s.t. &\qquad f_i(\mathbf{x}) \geq 0, &i = 1, \cdots, m \end{aligned}

二次规划问题:所有约束都是x\mathbf{x}的线性函数的时候

minf(x)=12xTGx+cTx+ds.t.Aix=b1A2x≥b2\begin{aligned} min &\qquad f(\mathbf{x})=\frac{1}{2}\mathbf{x}^TG\mathbf{x} + \mathbf{c}^T\mathbf{x} + d& \\ s.t. &\qquad A_i\mathbf{x} = \mathbf{b}_1 \\ &\qquad A_2\mathbf{x} \geq \mathbf{b}_2 \end{aligned}


可行点:点满足最优化模型中所有约束条件
可行域:所有可行点的全体

  • 最优化问题一般很难解决
  • 一般解决方法多少有一些妥协
    • 非常长的计算时间
    • 不是总是能找到结果

凸优化问题

minf0(x)s.t.fi(x)<0,i=1,⋯ ,maiTx=bi,i=1,⋯ ,p\begin{aligned} min &\qquad f_0(\mathbf{x}) & \\ s.t. &\qquad f_i(\mathbf{x}) < 0, &i = 1, \cdots, m \\ &\qquad \mathbf{a}^T_i\mathbf{x} = \mathbf{b}_i, &i = 1, \cdots, p \end{aligned}

上述优化问题中,fi(x)f_i(\mathbf{x})是凸函数,此类问题称为凸优化问题
对比优化文图:目标函数和不等式约束为凸函数,等式约束时仿射函数的优化问题属于凸优化问题。

  • 凸优化的最优解集是凸集
  • 凸优化的局部最优解都是全局最优解

优化问题隐式约束

x∈D=⋂i=0mfi∩⋂i=2pdomhi\mathbf{x} \in \mathcal{D} = \bigcap^m_{i=0} f_i \cap \bigcap^p_{i=2} \mathbf{dom} h_i

  • D\mathcal{D}:问题的定义域,定义域外返回:+∞+\infty
  • fi(x)≤0,hi(x)=0f_i(\mathbf{x}) \leq 0, h_i(\mathbf{x}) = 0是显性约束条件
  • 问题是有约束,如果没有显性约束条件(m=p=0)(m=p=0)

相同的优化问题

2个问题可以是等价的,如果其中一个解能轻易的从另外一个问题中获得

例子

minf0(x)s.t.fi(x)<0,i=1,⋯ ,maiTx=bi,i=1,⋯ ,p\begin{aligned} min &\qquad f_0(\mathbf{x}) & \\ s.t. &\qquad f_i(\mathbf{x}) < 0, &i = 1, \cdots, m \\ &\qquad \mathbf{a}^T_i\mathbf{x} = \mathbf{b}_i, &i = 1, \cdots, p \end{aligned}

和

minf0(Fz+x0)s.t.fi(Fz+x0)<0,i=1,⋯ ,m\begin{aligned} min &\qquad f_0(F\mathbf{z} + \mathbf{x}_0) & \\ s.t. &\qquad f_i(F\mathbf{z} + \mathbf{x}_0) < 0, &i = 1, \cdots, m \end{aligned}

是等价的,其中F,x0F, \mathbf{x}_0对于一些z\mathbf{z}满足


minf0(A0x+b0)s.t.fi(Aix+b0)<0,i=1,⋯ ,m\begin{aligned} min &\qquad f_0(A_0\mathbf{x} + \mathbf{b}_0) & \\ s.t. &\qquad f_i(A_i\mathbf{x} + \mathbf{b}_0) < 0, &i = 1, \cdots, m \end{aligned}

等价于

minf0(y0)s.t.fi(yi)<0,i=1,⋯ ,myi=Aix+bi,i=1,⋯ ,m\begin{aligned} min &\qquad f_0(\mathbf{y_0}) & \\ s.t. &\qquad f_i(\mathbf{y_i}) < 0, &i = 1, \cdots, m \\ &\qquad \mathbf{y_i} = A_i\mathbf{x} + \mathbf{b}_i, &i = 1, \cdots, m \end{aligned}

优化问题基本概念

  • 凸集:定义目标函数和约束函数的定义域。
  • 凸函数:定义优化相关函数的凸性限制。
  • 凸优化:中心内容的标准描述。
  • 凸优化问题求解:核心内容。相关算法,梯度下降法、牛顿法、内点法等。
  • 对偶问题:将一般优化问题转化为凸优化问题的有效手段,求解凸优化问题的有效方法。

convexity means non-negative curvature, it means it curves up.

超平面

设D1,D2D_1, D_2为两个非空凸集,若存在a≠0,∀β∈R\mathbf{a} \neq 0, \forall \beta \in \mathbb{R},使得

H={x∈Rn ∣ aTx=β}\begin{aligned} H = \lbrace \mathbf{x} \in \mathbb{R}^n\ |\ \mathbf{a}^T\mathbf{x} = \beta \rbrace \end{aligned}

分离了集合D1D_1和D2D_2,称HH为超平面

∀d∈D1→aTd≥β∀d∈D2→aTd≤β\begin{aligned} \forall \mathbf{d} \in D_1 \rightarrow \mathbf{a}^T\mathbf{d} \geq \beta \\ \forall \mathbf{d} \in D_2 \rightarrow \mathbf{a}^T\mathbf{d} \leq \beta \end{aligned}

  • 二维分割需要一条线,三维分割需要一个面,所以NN维分割需要N−1N-1维的超平面
  • 超平面可以表示为aTx=β\mathbf{a}^T\mathbf{x} = \beta

多面体

多面体被定义为有限个线性等式和不等式的解集

P={x ∣ aTx≤bj,j=1,2,⋅,m,cjT=dj,j=1,2,⋅,p}\mathcal{P} = \lbrace x\ |\ a^Tx \leq b_j, j = 1,2,\cdot,m, c^T_j = d_j, j= 1,2,\cdot,p \rbrace

  • 几何上来看,多面体是有限个半空间和超平面的交集
  • 多面体是凸集,有界多面体也成为多胞形,表示为P={x ∣ Ax≤b,Cx=d}\mathcal{P} = \lbrace \mathbf{x}\ |\ A\mathbf{x} \leq b, C\mathbf{x} = d \rbrace
  • 以下几何都是多面体
    • 仿射几何
      • 子空间
      • 超平面
      • 直线
    • 射线
    • 线段
    • 半空间

向量不等式

符号:⪯,>\preceq, >
代表Rm\mathbb{R}^m上的向量不等式或分量不等式

u⪯v表示ui≤vi,1=1,2,⋯ ,m\begin{aligned} \mathbf{u} &\preceq \mathbf{v} \\ &\text{表示} \\ u_i \leq v_i, &\quad 1 = 1,2,\cdots,m \end{aligned}

广义不等式

称锥K⊆RnK \subseteq \mathbb{R}^n为正常锥,如果它满足下列条件

  • KK是凸的
  • KK是闭的
  • KK是实的,即具有非空内部
  • KK是尖的,即不包含直线(x∈K,−x∈K⇒x=0\mathbf{x} \in K, -\mathbf{x} \in K \Rightarrow \mathbf{x} = 0)

正常锥KK可以用来定义广义不等式,即Rn\mathbb{R}^n上的偏序关系

x⪯Ky⇔y−x\mathbf{x} \preceq_K \mathbf{y} \Leftrightarrow \mathbf{y} - \mathbf{x}

单纯形

单纯体是一类多面体,设k+1k+1个点v0,⋅,vk∈Rnv_0, \cdot, v_k \in \mathbf{R}^n仿射独立,即

v1−v0,⋅,vk−v0v_1 - v_0, \cdot, v_k - v_0

线性独立,则这些点决定了一个单纯形

C=conv{v0,⋅,vk}={θ0v0,⋅,θ0vk ∣ θ>0,1Tθ=1}\begin{aligned} C &= \mathbf{conv}\lbrace v_0,\cdot, v_k\rbrace \\ &= \lbrace \theta_0v_0,\cdot, \theta_0v_k\ |\ \theta > 0, \mathbf{1}^T\theta = 1\rbrace \end{aligned}

  • 其中1\mathbf{1}表示所有分量均为1的向量
  • 这个单纯形的仿射维数为kk,称为Rn\mathbf{R}^n空间的kk维单纯形
  • 常见单纯性
    • 1维单纯形:一条线段
    • 2维单纯形:一个三角形
    • 3维单纯形:一个四面体

锥

对于任意x∈Cx \in C和θ≥0\theta \geq 0都有θx∈C\theta{}x \in C,我们称集合CC是锥或者非负齐次。
如果集合C是锥,并且是凸的,则称C为凸锥,即对∀x1,x2∈C\forall x_1, x_2 \in C和θ1,θ2≥0\theta{}_1, \theta{}_2 \geq 0,都有

θ1x1+θ2x2∈C\theta_1x_1 + \theta_2x_2 \in C

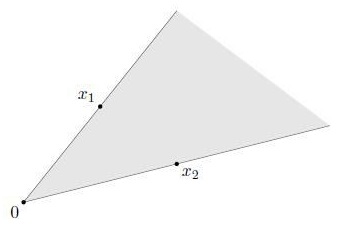
在几何上,具有此类形式的点构成了二维的扇形,这个扇形以0为顶点,边通过x1x_1和x2x_2

半正定锥

用SnS^n表示对称n×nn \times n矩阵的集合,即

S+n={X∈Rn×n∣X=XT}S^n_+ = \lbrace X \in \mathbb{R}^{n\times n} | X = X^T \rbrace

这是一个维数为n(n+1)/2n(n+1)/2的向量空间,我们用S+nS^n_+表示对称半正定矩阵的集合

S+n={X∈Sn∣X>0}S^n_+ = \lbrace X \in S^n | X > 0 \rbrace

用S++nS^n_{++}表示对称正定矩阵的集合

S++n={X∈Sn∣X≻0}S^n_{++} = \lbrace X \in S^n | X \succ 0 \rbrace

  • R+R_+:表示非负实数
  • R++R_{++}:表示正实数

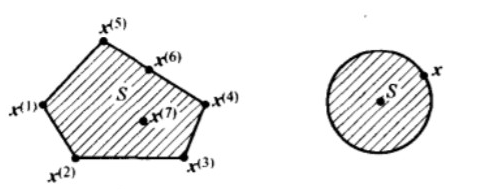
极点

设SS为非空集合,x∈S\mathbf{x} \in S,若x\mathbf{x}不能表示成SS中两个不同点的凸组合,即

x=λx1+(1−λ)x2,λ∈(0,1).x1,x2∈S\mathbf{x} = \lambda \mathbf{x}_1 + (1 - \lambda)\mathbf{x}_2, \quad \lambda \in (0, 1). \mathbf{x}_1, \mathbf{x}_2 \in S

则必有x=x1=x2\mathbf{x} = \mathbf{x}_1 = \mathbf{x}_2,则称x\mathbf{x}是凸集SS的极点

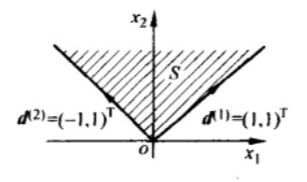
极方向

设SS为Rn\mathbb{R}^n中的闭凸集,d\mathbf{d}为非零向量,如果对SS中的每一个x\mathbf{x},都有射线

{x+λd ∣ λ≤0}⊂S\lbrace \mathbf{x} + \lambda\mathbf{d}\ |\ \lambda \leq 0 \rbrace \subset S

则称向量d\mathbf{d}为SS的方向,又设d1,d2\mathbf{d}_1, \mathbf{d}_2为SS的两个反向,若对任意整数λ\lambda,有d1≠λd2\mathbf{d}_1 \neq \lambda\mathbf{d}_2,则称d1,d2\mathbf{d}_1, \mathbf{d}_2是两个不同的方向,若SS的方向d\mathbf{d}不能表示成集合的两个不同方向的正的线性组合,则称d\mathbf{d}为SS的极方向

有界集不存在方向,也不存在极方向,无界集才有方向的概念

凸集

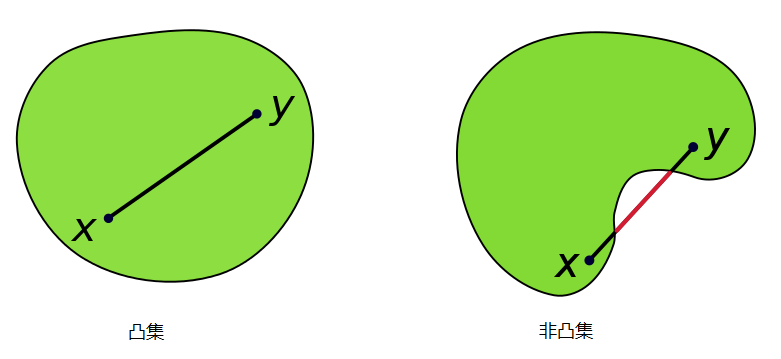
凸集(convex set)是一个点集合,其中每两点之间的直线点都落在该点集合中。

设S∈Rn\mathbf{S} \in \mathbb{R}^n(实或复向量空间的集), 若对于所有x,y∈S\mathbf{x}, \mathbf{y} \in \mathbf{S},和所有λ∈[0,1]\lambda \in [0, 1]存在λx+(1−λ)y∈S\lambda \mathbf{x} +(1 - \lambda)\mathbf{y} \in \mathbf{S},则S\mathbf{S}是凸集,其中λx+(1−λ)y\lambda \mathbf{x} +(1 - \lambda)\mathbf{y}称作点x,y\mathbf{x},\mathbf{y}之间的凸连接

例子:

设A∈Rm×n,b∈RnA \in \mathbb{R}^{m \times n}, b \in \mathbb{R}^n,证明S={x∈Rn∣Ax=b,x≥0}\mathbf{S} = \lbrace \mathbf{x} \in \mathbb{R}^n | A\mathbf{x} = \mathbf{b}, \mathbf{x} \geq 0 \rbrace{}是凸集。

证明流程:

{x,y∈Sλ∈[0,1]⇔(Ax=b,x≥0Ay=b,y≥0)\begin{cases} \mathbf{x}, \mathbf{y} \in \mathbf{S} \\ \lambda \in [0, 1] \end{cases} \Leftrightarrow \begin{pmatrix} A\mathbf{x}=b, \mathbf{x} \geq 0 \\ A\mathbf{y}=b, \mathbf{y} \geq 0 \end{pmatrix}

w=λx+(1−λ)y∈S⇔(Aw=b,w≥0)\mathbf{w} = \lambda \mathbf{x}+(1 - \lambda)\mathbf{y} \in \mathbf{S} \Leftrightarrow (A\mathbf{w} = \mathbf{b}, \mathbf{w} \geq 0)

典型的凸集

  • 线段,射线,直线
  • 超平面,半空间
  • 仿射集
  • 欧几里得球,范数球,椭球等
  • 凸锥,范数锥等

凸函数

函数f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R}定义域domf\mathbf{dom} f是凸集,且对于∀x,y∈domf\forall{} \mathbf{x}, \mathbf{y} \in \mathbf{dom} f和∀θ,0≤θ≤1\forall\theta, 0\leq \theta \leq 1有

f(θx+(1−θ)y)≤θf(x)+(1−θ)f(y)f(\theta{}\mathbf{x} + (1-\theta)\mathbf{y}) \leq \theta{}f(\mathbf{x}) + (1-\theta)f(y)

则称函数ff是凸函数

凸函数与凸集合的关系:

下水平集:函数ff的下水平集Ca={x∈domf ∣ f(x)≤a}C_a = \lbrace \mathbf{x} \in \mathbf{dom} f\ |\ f(\mathbf{x}) \leq a\rbrace是其定义域的子集,凸函数的下水平集是凸集
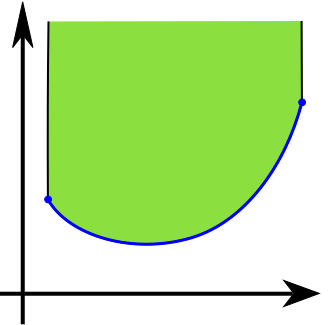
上镜图:函数f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R}的上镜图epif={(x,t) ∣ x∈domf,f(x)≤t}\mathbf{epi} f = \lbrace(\mathbf{x}, t)\ |\ \mathbf{x} \in \mathbf{dom} f, f(\mathbf{x}) \leq t\rbrace,他是Rn+1\mathbb{R}^{n+1}空间的子集。

狭义凸函数

f(θx+(1−θ)y)<θf(x)+(1−θ)f(y)f(\theta{}\mathbf{x} + (1-\theta)\mathbf{y}) < \theta{}f(\mathbf{x}) + (1-\theta)f(\mathbf{y})

凸函数与凸集合的关系

定理:如果SS是Rn\mathbb{R}^n中的一个凸集,ff是定义在SS上的凸函数,则ff在SS内部连续

凸函数与凸集的关系:一个函数是凸函数,当且仅当其上镜图是凸集

典型凸函数

  • 线性函数和仿射函数:f(x)=aTx+bf(\mathbf{x}) = \mathbf{a}^T\mathbf{x} + b
  • 指数函数
  • 负熵
  • 范数:∥x∥p\parallel \mathbf{x}\parallel _p

设f,g:Rn→Rf, g: \mathbb{R}^n \rightarrow \mathbb{R}是凸函数,λ>0\lambda > 0

  • f+gf + g
  • λf\lambda f
  • max⁡(f,g)\max(f, g)

都是凸函数

函数 式子 ∇f(x)\nabla f(\mathbf{x}) ∇2f(x)\nabla^2 f(\mathbf{x})
二次型 f(x)=12xTPx+qTx+rf(\mathbf{x}) = \frac{1}{2}\mathbf{x}^TP\mathbf{x} + q^T\mathbf{x} +r ∇f(x)=Px+q\nabla f(\mathbf{x}) = P\mathbf{x} + q ∇2f(x)=P\nabla^2 f(\mathbf{x})=P
最小二乘 f(x)=∥Ax−b∥22f(\mathbf{x}) =\parallel A\mathbf{x}- b\parallel ^2_2 ∇f(x)=2AT(Ax−b)\nabla f(\mathbf{x}) = 2A^T(A\mathbf{x} - b) ∇2f(x)=2ATA\nabla^2 f(\mathbf{x})=2A^TA

凸函数性质

凸函数的重要特性:任意局部最优解也是全局最优解

设f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R}

x∗\mathbf{x}^*全局的最小解:f(x∗)≤f(x),∀x∈Rnf(\mathbf{x}^*) \leq f(\mathbf{x}), \forall \mathbf{x} \in \mathbb{R}^n
x∗\mathbf{x}^*局部的最小解:∃ε>0,f(x∗)≤f(x),∀x→∣x∗−x∣<ε\exists \varepsilon > 0, f(\mathbf{x}^*) \leq f(\mathbf{x}), \forall \mathbf{x} \rightarrow |\mathbf{x}^* - \mathbf{x}| < \varepsilon

一般来说:找到局部的最小解即可

一阶条件

可微函数ff是凸函数的充要条件是

  • 定义域domf\mathbf{dom} f是凸集
  • 对于∀x,y∈R\forall{} \mathbf{x},\mathbf{y} \in \mathbb{R}有

[∇f(x)−∇f(y)]T(x−y)≥0[\nabla{}f(\mathbf{x}) - \nabla{}f(\mathbf{y})]^T(\mathbf{x} - \mathbf{y}) \geq 0

  • 对于∀x,y∈domf\forall{} \mathbf{x},\mathbf{y} \in \mathbf{dom} f有

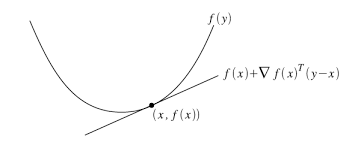
f(y)≥f(x)+∇f(x)T(y−x)f(\mathbf{y}) \geq f(\mathbf{x}) + \nabla f(\mathbf{x})^T(\mathbf{y}-\mathbf{x})

f(x)+∇f(x)T(y−x)f(\mathbf{x}) + \nabla f(\mathbf{x})^T(\mathbf{y}-\mathbf{x})即函数f(y)f(\mathbf{y})在点x\mathbf{x}附近的Taylor近似。对于一个凸函数

  • 其一阶Taylor近似实质上是原函数的一个全局下估计
  • 某函数的一阶Taylor近似总是全局下估计,则这个函数是凸的

简单的来说:对于函数在定义域的任意取值,函数的值都大于或等于对这个函数在这一点的一阶近似

二阶条件

函数ff的二阶偏导函数称为函数ff的Hessian矩阵(黑塞矩阵)
对于函数ff定义域domf\mathbf{dom} f内任意一点,其Hessian矩阵存在,则函数ff是凸函数的充要条件是

∀x∈domf→∇2f(x)>0\forall \mathbf{x} \in \mathbf{dom} f \rightarrow \nabla^2 f(\mathbf{x}) > 0

同理可以等价于:

  • Hessian矩阵是半正定矩
  • 对于R\mathbb{R}上的函数,可以简化为f′′(x)≥0f''(\mathbf{x}) \geq 0(ff导函数非减)
  • 从几何上理解就是函数图像在点x\mathbf{x}处有正(向上)的曲率

保凸运算

非负加权求和

如果函数f1f_1和f2f_2都是凸函数,则f1+f2f_1 + f_2也是凸函数

复合仿射映射

假设函数f:Rn→R,A∈Rn×mf: \mathbb{R}^n \rightarrow \mathbb{R}, A \in \mathbb{R}^{n\times m},以及b∈Rnb \in \mathbb{R}^n,定义g:Rm→Rg: \mathbb{R}^m \rightarrow \mathbb{R}为

g(x)=f(Ax+b)g(\mathbf{x}) = f(A\mathbf{x} + b)

其中domg={x ∣ Ax+b∈domf}\mathbf{dom} g = \lbrace \mathbf{x}\ |\ A\mathbf{x} + b \in \mathbf{dom} f \rbrace

  • 若函数ff是凸函数,则函数gg是凸函数
  • 若函数ff是凹函数,则函数gg是凹函数
逐点最小和逐点下确界

如果函数f1f_1和f2f_2均为凸函数,则二者的逐点最小函数ff

f(x)=min⁡(f1(x),f2(x))f(\mathbf{x}) = \min(f_1(\mathbf{x}), f_2(\mathbf{x}))

其定义域为domf=domf1∩domf2\mathbf{dom} f = \mathbf{dom} f_1 \cap \mathbf{dom} f_2,仍然时凸函数

证明:

∀θ∈[0,1],x,y∈domf\forall \theta \in [0, 1], \mathbf{x}, \mathbf{y} \in \mathbf{dom} f,则

f(θx+(1−θ)y)=min⁡(f1(θx+(1−θ)y),f2(θx+(1−θ)y))≤min⁡(θf1(x)+(1−θ)f1(y),θf2(x)+(1−θ)f2(y))≤θmin⁡(f1(x),f2(x))+(1−θ)min⁡(f1(y),f2(y))=θf(x)+(1−θ)f(y)\begin{aligned} f(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y}) &=\min(f_1(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y}), f_2(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y})) \\ &\leq\min(\theta{}f_1(\mathbf{x}) + (1 - \theta)f_1(\mathbf{y}), \theta{}f_2(\mathbf{x}) + (1-\theta)f_2(\mathbf{y})) \\ &\leq \theta{}\min(f_1(\mathbf{x}), f_2(\mathbf{x})) + (1 - \theta)\min(f_1(\mathbf{y}), f_2(\mathbf{y})) \\ &=\theta{}f(\mathbf{x}) + (1-\theta)f(\mathbf{y}) \end{aligned}

同理,可得出

f(x)=min⁡(f1(x),f2(x),⋯ ,fm(x))f(\mathbf{x}) = \min(f_1(\mathbf{x}), f_2(\mathbf{x}), \cdots, f_m(\mathbf{x}))

仍然是凸函数


铸点最大的性质可以扩展至无限个凸函数的逐点下确界。如果对于任意y∈Ay \in \mathcal{A},函数f(x,y)f(x,y)关于xx都是凸的,则函数gg

g(x)=inf⁡y∈Af(x,y)g(x) = \inf_{y \in \mathcal{A}}f(x,y)

关于xx也是凸函数,定义域为

domg={x ∣ (x,y)∈domf∀y∈A,inf⁡y∈Af(x,y)<∞}\mathbf{dom} g = \lbrace x\ |\ (x, y) \in \mathbf{dom} f \forall y \in \mathcal{A}, \inf_{y \in \mathcal{A}} f(x, y) < \infty \rbrace

inf⁡\inf:最大下界

  • ∀s∈S⇒s≥inf⁡(S)\forall s \in S \Rightarrow s \geq \inf(S)

证明:

f(θx1+(1−θ)x2)=inf⁡f(θx1+(1−θ)x2,y)≤f(θx1+(1−θ)x2,θy1+(1−θ)y2)≤θf(x1,y1)+(1−θ)f(x2,y2)=θg(x1)+(1−θ)g(x2)+ϵ\begin{aligned} f(\theta{}\mathbf{x}_1 + (1 - \theta)\mathbf{x}_2) &=\inf f(\theta{}\mathbf{x}_1 + (1 - \theta)\mathbf{x}_2, \mathbf{y}) \\ &\leq f(\theta{}\mathbf{x}_1 + (1 - \theta)\mathbf{x}_2, \theta{}\mathbf{y}_1 + (1-\theta)\mathbf{y}_2) \\ &\leq \theta{}f(\mathbf{x}_1, \mathbf{y}_1) + (1 - \theta)f(\mathbf{x}_2, \mathbf{y}_2) \\ &=\theta{}g(\mathbf{x}_1) + (1-\theta)g(\mathbf{x}_2) + \epsilon \end{aligned}

对∀ϵ\forall \epsilon成立,于是

f(θx1+(1−θ)x2)=θg(x1)+(1−θ)g(x2)f(\theta{}\mathbf{x}_1 + (1 - \theta)\mathbf{x}_2) = \theta{}g(\mathbf{x}_1) + (1-\theta)g(\mathbf{x}_2)

逐点最大和逐点上确界

如果函数f1f_1和f2f_2均为凸函数,则二者的逐点最大函数ff

f(x)=max⁡(f1(x),f2(x))f(\mathbf{x}) = \max(f_1(\mathbf{x}), f_2(\mathbf{x}))

其定义域为domf=domf1∩domf2\mathbf{dom} f = \mathbf{dom} f_1 \cap \mathbf{dom} f_2,仍然时凸函数

证明:

∀θ∈[0,1],x,y∈domf\forall \theta \in [0, 1], \mathbf{x}, \mathbf{y} \in \mathbf{dom} f,则

f(θx+(1−θ)y)=max⁡(f1(θx+(1−θ)y),f2(θx+(1−θ)y))≤max⁡(θf1(x)+(1−θ)f1(y),θf2(x)+(1−θ)f2(y))≤θmax⁡(f1(x),f2(x))+(1−θ)max⁡(f1(y),f2(y))=θf(x)+(1−θ)f(y)\begin{aligned} f(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y}) &=\max(f_1(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y}), f_2(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y})) \\ &\leq\max(\theta{}f_1(\mathbf{x}) + (1 - \theta)f_1(\mathbf{y}), \theta{}f_2(\mathbf{x}) + (1-\theta)f_2(\mathbf{y})) \\ &\leq \theta{}\max(f_1(\mathbf{x}), f_2(\mathbf{x})) + (1 - \theta)\max(f_1(\mathbf{y}), f_2(\mathbf{y})) \\ &=\theta{}f(\mathbf{x}) + (1-\theta)f(\mathbf{y}) \end{aligned}

同理,可得出

f(x)=max⁡(f1(x),f2(x),⋯ ,fm(x))f(\mathbf{x}) = \max(f_1(\mathbf{x}), f_2(\mathbf{x}), \cdots, f_m(\mathbf{x}))

仍然是凸函数


铸点最大的性质可以扩展至无限个凸函数的逐点上确界。如果对于任意y∈Ay \in \mathcal{A},函数f(x,y)f(x,y)关于xx都是凸的,则函数gg

g(x)=sup⁡y∈Af(x,y)g(x) = \sup_{y \in \mathcal{A}}f(x,y)

关于xx也是凸函数,定义域为

domg={x ∣ (x,y)∈domf∀y∈A,sup⁡y∈Af(x,y)<∞}\mathbf{dom} g = \lbrace x\ |\ (x, y) \in \mathbf{dom} f \forall y \in \mathcal{A}, \sup_{y \in \mathcal{A}} f(x, y) < \infty \rbrace

sup⁡\sup:最小上界

  • ∀s∈S⇒s≤sup⁡(S)\forall s \in S ⇒ s \leq \sup(S)
标量复合函数

假设函数f:Rn→R,h:R→Rf: \mathbb{R}^n \rightarrow \mathbb{R}, h: \mathbb{R} \rightarrow \mathbb{R},令

f(x)=h(g(x))f(\mathbf{x}) = h(g(\mathbf{x}))

满足以下条件的时,ff是凸函数

  • hh是凸函数,gg是凸函数,h~\tilde{h}是非减的
  • hh是凸函数,gg是凹函数,h~\tilde{h}是非增的
  • h~\tilde{h}:extended value extension of hh

证明:

f′′(x)=h′′(g(x))g′(x)2+h′(g(x))g′′(x)f''(\mathbf{x}) = h''(g(\mathbf{x}))g'(\mathbf{x})^2 + h'(g(\mathbf{x}))g''(\mathbf{x})

在实数域上,若gg是凸函数,则g′′>0g'' > 0,若hh是凸函数且非减,则h′′≥0,h′≥0h'' \geq 0, h' \geq 0,可以得出f′′≥0f'' \geq 0,即函数ff是凸函数

hh gg ff
凸函数,非减 凸函数 凸函数
凸函数,非增 凹函数 凸函数
凹函数,非减 凹函数 凹函数
凹函数,非增 凸函数 凹函数
矢量复合函数

f(x)=h(g(x))=h(g1(x),g2(x),⋯ ,gk(x))f(\mathbf{x}) = h(g(\mathbf{x})) = h(g_1(\mathbf{x}), g_2(\mathbf{x}), \cdots, g_k(\mathbf{x}))

满足以下条件的时,ff是凸函数

  • hh是凸函数,gg是凸函数,h~\tilde{h}对于每个参数都是非减的
  • hh是凸函数,gg是凹函数,h~\tilde{h}对于每个参数都是非增的
  • h~\tilde{h}:extended value extension of hh

证明:

f′′(x)=g′(x)T∇2h(g(x))g′(x)+∇h(g(x))Tg′′(x)f''(\mathbf{x}) = g'(\mathbf{x})^T\nabla^2h(g(\mathbf{x}))g'(\mathbf{x}) + \nabla h(g(\mathbf{x}))^Tg''(\mathbf{x})

Jensen不等式及其扩展

基本不等式,也称Jensen不等式,如果ff是凸函数,对于任意0≤θ≤10 \leq \theta \leq 1

f(θx+(1−θ)y)≤θf(x)+(1−θ)f(y)f(\theta{}\mathbf{x} + (1 - \theta)\mathbf{y}) \leq \theta{}f(\mathbf{x}) + (1 - \theta)f(\mathbf{y})

如果ff是凸函数,对于任意z∈domf\mathbf{z} \in \mathbf{dom} f,有

f(Ez)≤Ef(z)⇓f(θ1x1+⋯+θkxk)≤θ1f(x1)+⋯+θkf(xk)θ1+⋯+θk=1\begin{aligned} f(\mathbf{E}\mathbf{z}) &\leq \mathbf{E}f(\mathbf{z}) \\ &\Downarrow \\ f(\theta_1x_1 + \cdots + \theta_kx_k) &\leq \theta_1f(x_1) + \cdots + \theta_kf(x_k) \\ \theta_1 + &\cdots + \theta_k = 1 \end{aligned}

共轭函数

方向导数

设SS是Rn\mathbf{R}^n中的一个集合,ff是定义在SS上的实函数,x‾∈∫S\overline{\mathbf{x}} \in \int S(表示集合SS的内部),d\mathbf{d}是非零向量,ff在x‾\overline{\mathbf{x}}沿着方向d\mathbf{d}的方向导数Df(x‾;d)Df(\overline{\mathbf{x}}; \mathbf{d})定义为

Df(x‾;d)=lim⁡λ→0f(x‾+λd)−f(x‾)λDf(\overline{\mathbf{x}}; \mathbf{d}) = \lim_{\lambda \rightarrow 0} \frac{f(\overline{\mathbf{x}} + \lambda \mathbf{d}) - f(\overline{\mathbf{x}})}{\lambda}

  • ffz在x‾\overline{x}处沿着方向dd的右侧导数

Df(x‾;d)=lim⁡λ→0+f(x‾+λd)−f(x‾)λDf(\overline{\mathbf{x}}; \mathbf{d}) = \lim_{\lambda \rightarrow 0^+} \frac{f(\overline{\mathbf{x}} + \lambda \mathbf{d}) - f(\overline{\mathbf{x}})}{\lambda}

  • ffz在x‾\overline{x}处沿着方向dd的左侧导数

Df(x‾;d)=lim⁡λ→0−f(x‾+λd)−f(x‾)λDf(\overline{\mathbf{x}}; \mathbf{d}) = \lim_{\lambda \rightarrow 0^-} \frac{f(\overline{\mathbf{x}} + \lambda \mathbf{d}) - f(\overline{\mathbf{x}})}{\lambda}

−D+f(x‾;−d)=D−f(x‾;d)-D^+f(\overline{\mathbf{x}}; -\mathbf{d}) = D^-f(\overline{\mathbf{x}}; \mathbf{d})

如果对某个x‾\overline{x}和方向d\mathbf{d}有

D+f(x‾;d)=D−f(x‾;d)D^+f(\overline{\mathbf{x}}; \mathbf{d}) = D^-f(\overline{\mathbf{x}}; \mathbf{d})

则存在方向导数

  • 若方向d\mathbf{d}为单位向量ei\mathbf{e}_i,则ff在x‾\overline{x}处沿方向导数正好等于ff对xix_i的偏导数
  • 如果ff在x‾\overline{x}可微,则ff在x‾\overline{x}处沿任何方向d‾\overline{d}的方向导数是有限的⇒Df(x‾,d)=dT∇f(x‾)\Rightarrow Df(\overline{\mathbf{x}}, \mathbf{d}) = \mathbf{d}^T\nabla f(\overline{\mathbf{x}})

设ff是一个凸函数,x∈Rnx \in \mathbb{R}^n,在xx处函数f(x)f(x)取有极值,则ff在xx处沿任何方向d\mathbf{d}的左侧导数及左侧导数都存在

梯度

定义函数:f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R}
函数ff的梯度为

∇f(x)=(∂f∂x1⋮∂f∂xn)∈Rn\nabla f(\mathbf{x}) = \begin{pmatrix} \frac{\partial f}{\partial x_1} \\ \vdots \\ \frac{\partial f}{\partial x_n} \end{pmatrix} \in \mathbb{R}^n

  • 是一个矢量
  • 其方向上的方向导数最大,其大小正好是此最大方向导数
  • 所有方向导数中会存在并且只存在一个最大值
  • 偏导数连续才有梯度存在

通俗的来说,二维平面函数每个点只有一个切线,三位平面上一个点有无数个切线,而梯度就是这个点导数最大的切线的矢量。

梯度方向是函数变化率最大的方向

Hessian矩阵

函数ff所有二阶偏导数都存在并在定义域内连续,那么函数ff的Hessian矩阵为

∇2f(x)=[成分(i,j)=∂2f∂xixj的矩阵]\nabla^2f(\mathbf{x}) = [\text{成分}(i, j) = \frac{\partial^2 f}{\partial x_i x_j}\text{的矩阵}]

  • Hessian矩阵是对称矩阵
  • Hessian矩阵的特征值形容其在该点附近特征向量方向的凹凸性,特征值越大,凸性越强。

假设在开集S⊂RnS \subset \mathbb{R}^n上f∈C2(S)f \in C^2(S),则ff在x‾∈S\overline{\mathbf{x}} \in S的一阶泰勒展开式为

f(x)=f(x‾)+∇f(x‾)T(x−x‾)+o(∥x−x‾∥)f(\mathbf{x}) = f(\overline{\mathbf{x}}) + \nabla f(\overline{\mathbf{x}})^T(\mathbf{x} - \overline{\mathbf{x}}) + o(\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel)

其中o(∥x−x‾∥)o(\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel)是当∥x−x‾∥→0\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel \rightarrow 0时,关于∥x−x‾∥\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel的高阶无穷小量

二阶泰勒展开式为

f(x)=f(x‾)+∇f(x‾)T(x−x‾)+12(x−x‾)T∇2f(x‾)(x−x‾)+o(∥x−x‾∥2)f(\mathbf{x}) = f(\overline{\mathbf{x}}) + \nabla f(\overline{\mathbf{x}})^T(\mathbf{x} - \overline{\mathbf{x}}) + \frac{1}{2}(\mathbf{x} - \overline{\mathbf{x}})^T \nabla^2f(\overline{\mathbf{x}})(\mathbf{x} - \overline{\mathbf{x}}) + o(\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel^2)

其中o(∥x−x‾∥2)o(\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel^2)是当∥x−x‾∥2→0\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel^2 \rightarrow 0时,关于∥x−x‾∥2\parallel \mathbf{x} - \overline{\mathbf{x}} \parallel^2的高阶无穷小量

Hessian矩阵相关公式

设c,Q∈Rn\mathbf{c}, Q \in \mathbb{R}^n

  • ∇(cTx)=c\nabla(\mathbf{c}^T\mathbf{x}) = \mathbf{c}
  • ∇(xQTx)=Q+QTx=2Qx\nabla(\mathbf{x}Q^T\mathbf{x})=Q+Q^T\mathbf{x}=2Q\mathbf{x}
  • ∇2(xTQx)=Q+QT=2Q\nabla^2(\mathbf{x}^TQ\mathbf{x})=Q+Q^T=2Q
  • ∇f(x)=Qx+c, ∇2f(x)=Q\nabla f(\mathbf{x})=Q\mathbf{x}+\mathbf{c},\ \nabla^2f(\mathbf{x})=Q

二次函数的Hessian矩阵

二次函数可以写成以下形式

f(x)=12xAx+bTx+cf(\mathbf{x}) = \frac{1}{2}\mathbf{x}A\mathbf{x}+ \mathbf{b}^T\mathbf{x} + c

  • 其中AA是对称矩阵,bb是nn维向量
  • 梯度:∇f(x=Ax+b\nabla f(\mathbf{x} = A \mathbf{x} + \mathbf{b}
  • Hessian矩阵:∇2f(x)=A\nabla^2 f(x) = A

无约束优化问题

设函数f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R}是二次可微函数(意味着domf\mathbf{dom}f是开集),求解

minf(x)\begin{aligned} min &\qquad f(\mathbf{x}) \end{aligned}

由于函数可微,则最优点x∗\mathbf{x}^*应该满足

f(x∗)=0,(x∗:local min)\begin{aligned} f(\mathbf{x}^*) = 0, \quad (\mathbf{x}^*: local\ min) \end{aligned}

  • 可以通过解析求解最优性方程
  • 采用迭代算法求解方程f(x∗)=0f(\mathbf{x}^*) = 0
  1. 即计算点列x0,x1,⋯ ,xk∈domf\mathbf{x}_{0},\mathbf{x}_{1},\cdots,\mathbf{x}_{k} \in \mathbf{dom}f
  2. 使k→∞k \rightarrow \infty时,f(xk)→inf⁡xf(x)f(\mathbf{x}_{k}) \rightarrow \inf_xf(\mathbf{x})
  3. 当f(xk)−inf⁡xf(x)≤εf(\mathbf{x}_{k}) - \inf_xf(\mathbf{x}) \leq \varepsilon时,算法终止,ε\varepsilon容许误差值

停留点

2变量的情况:

条件 结果
{fxxfyy−fxy2>0fxx>0\begin{cases}f_{xx}f_{yy} - f_{xy}^2 > 0\\f_{xx} > 0\end{cases} 极大点
{fxxfyy−fxy2>0fxx<0\begin{cases}f_{xx}f_{yy} - f_{xy}^2 > 0\\f_{xx} < 0\end{cases} 极小点
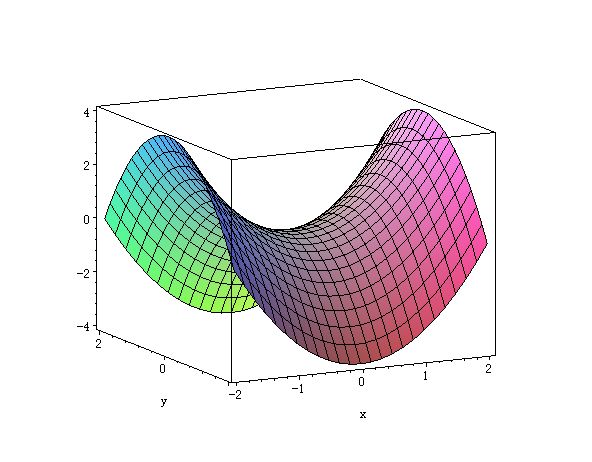
fyy−fxy2<0f_{yy} - f_{xy}^2 < 0 鞍点
fyy−fxy2=0f_{yy} - f_{xy}^2 = 0 不确定

多变量的情况:

条件 结果
∇f(x)=0,∇2f(x)\nabla f(\mathbf{x}) = 0, \nabla^2f(\mathbf{x}) 正定矩阵 局部极小点
∇f(x)=0,∇2f(x)\nabla f(\mathbf{x}) = 0, \nabla^2f(\mathbf{x}) 负定矩阵 局部极大点
∇f(x)=0,∇2f(x)\nabla f(\mathbf{x}) = 0, \nabla^2f(\mathbf{x}) 不定矩阵 鞍点
det⁡∇2f(x)=0\det \nabla^2f(\mathbf{x}) = 0 不确定

泰勒定理

设f:Rn→Rf: \mathbb{R}^n \rightarrow \mathbb{R},设Δd∈Rn\Delta \mathbf{d} \in \mathbb{R}^n,存在t∈(0,1)t \in (0,1),有

阶数 公式 对应方法
C1C^1函数 f(x+Δd)=f(x)+∇f(x+tΔd)TΔdf(\mathbf{x} + \Delta \mathbf{d}) = f(\mathbf{x}) + \nabla f(\mathbf{x} + t\Delta \mathbf{d})^T\Delta \mathbf{d} 最速下降法
C2C^2函数 f(x+Δd)=f(x)+∇f(x+tΔd)TΔd+12ΔdT∇2f(x+tΔd)Δdf(\mathbf{x} + \Delta \mathbf{d}) = f(\mathbf{x}) + \nabla f(\mathbf{x} + t\Delta \mathbf{d})^T\Delta \mathbf{d} + \frac{1}{2}\Delta \mathbf{d}^T\nabla^2f(\mathbf{x} + t\Delta \mathbf{d})\Delta \mathbf{d} 牛顿法,拟牛顿法

一阶近似的最优解

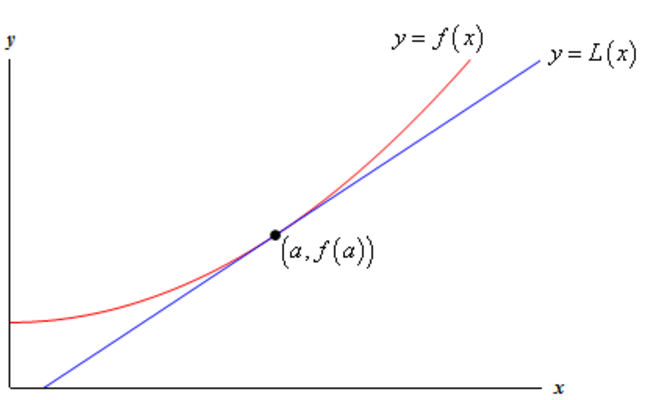
其意义是:函数从f(x)→f(x+Δd)f(\mathbf{x}) \rightarrow f(\mathbf{x} + \Delta \mathbf{d})的变化等于ff在某一点的梯度和向量Δd\Delta \mathbf{d}的点积,这个点总能在x\mathbf{x}和x+Δd\mathbf{x}+\Delta \mathbf{d}之间找到,但是每个Δd\Delta \mathbf{d}对应着不同的tt,如果允许一定误差的话,可以用∇f(x)\nabla f(\mathbf{x})代替∇f(x+tΔd)\nabla f(\mathbf{x}+t\Delta \mathbf{d})进行估测,即

f(x+Δd)=f(x)+∇f(x)TΔdf(\mathbf{x} + \Delta \mathbf{d}) = f(\mathbf{x}) + \nabla f(\mathbf{x})^T\Delta \mathbf{d}

因为

[f(x)+∇f(x)TΔd]−[f(x)+∇f(x+tΔd)TΔd]=(∇f(x)−∇f(x+tΔd))TΔd[f(\mathbf{x}) + \nabla f(\mathbf{x})^T\Delta \mathbf{d}] - [f(\mathbf{x}) + \nabla f(\mathbf{x} + t\Delta \mathbf{d})^T\Delta \mathbf{d}] = (\nabla f(\mathbf{x}) - \nabla f(\mathbf{x} + t\Delta \mathbf{d}))^T\Delta \mathbf{d}

如果Δd\Delta \mathbf{d}足够小,那么∇f(x)−∇f(x+tΔd)\nabla f(\mathbf{x}) - \nabla f(\mathbf{x} + t\Delta \mathbf{d})也足够小,从而误差也同样小

在几何上的表现为,假设ff是一个一维函数,上诉做法即在点(x,f(x))(\mathbf{x}, f(\mathbf{x}))做一条切线(一阶泰勒展开),在Δd\Delta \mathbf{d}足够小的情况下,这条切线和实际函数非常接近

泰勒定理为我们提供了一种搜索一个函数极小点的方法,我们可以选择一个初始点x0\mathbf{x}_0,如果选择一个方向Δd∈R\Delta \mathbf{d} \in \mathbb{R}且满足∇f(x)TΔd<0\nabla f(\mathbf{x})^T\Delta\mathbf{d} < 0,则存在t>0t > 0,使得

f(x+tΔd)<f(x)f(\mathbf{x} + t\Delta \mathbf{d}) < f(\mathbf{x})

如此迭代下去,f(x)f(\mathbf{x})的取值会越来越小,最后收敛到一个局部最小点,这样的方法称作直线搜索,其主要问题就是找到

  • 搜索步径
  • 比例因子

二阶近似的最优解

同理一阶近似的最优解,


1次:f(x+d)=f(x∗)+∇f(x)Td+残差f(\mathbf{x} + d) = f(\mathbf{x}^*) + \nabla f(\mathbf{x})^Td + \text{残差}
2次:f(x+d)=f(x∗)+∇f(x)Td+12dT∇2f(x)d+残差f(\mathbf{x} + d) = f(\mathbf{x}^*) + \nabla f(\mathbf{x})^Td + \frac{1}{2}d^T\nabla^2f(\mathbf{x})d + \text{残差}
1元:f(x+d)=f(x)+f′(x)d+12f′′(x)Td2+残差f(\mathbf{x} + d) = f(\mathbf{x}) + f'(\mathbf{x})d + \frac{1}{2}f''(\mathbf{x})^Td^2 + \text{残差}

下降方法

goal∇f(x∗)=0,(x∗:local min)\begin{aligned} goal &\qquad \nabla f(\mathbf{x}^*) = 0, \quad (\mathbf{x}^*: local\ min) \end{aligned}

本算法将产生一个优化点列xk,k=1,2,⋯\mathbf{x}_{k}, k =1,2,\cdots,其中

xk+1=xk+tkΔdk\mathbf{x}_{k+1} = \mathbf{x}_{k} + t_{k}\Delta \mathbf{d}_{k}

并且tk>0t_{k} > 0(除非xk\mathbf{x}_{k}已经是最优点)

  • 搜索步径:Δdk\Delta \mathbf{d}_{k}
  • 比例因子:tkt_{k}第kk次迭代的步进

只要xk\mathbf{x}_{k}不是最优点,则有

f(xk+1)<f(xk)f(\mathbf{x}_{k+1}) < f(\mathbf{x}_{k})

对于xk∈domf\mathbf{x}_{k} \in \mathbf{dom}f,由凸性可知

∇f(xk)T(y−xk)≥0y−xk≥0y≥xkf(y)≥f(xk)\begin{aligned} \nabla f(\mathbf{x}_{k})^T(\mathbf{y} - \mathbf{x}_{k}) &\geq 0 \\ \mathbf{y} - \mathbf{x}_{k} &\geq 0 \\ \mathbf{y} &\geq \mathbf{x}_{k} \\ f(\mathbf{y}) &\geq f(\mathbf{x}_{k}) \end{aligned}

因此下降方法中搜索方向必须满足

∇f(xk)TΔdk<0\begin{aligned} \nabla f(\mathbf{x}_{k})^T\Delta \mathbf{d}_{k} < 0 \end{aligned}

即

lim⁡t→+0f(xk+tkΔdk)−f(xk)tk<0\lim_{t \rightarrow +0}\frac{f(\mathbf{x}_{k} + t_{k}\Delta \mathbf{d}_{k}) - f(\mathbf{x}_{k})}{t_{k}} < 0

也就是负梯度方向的夹角必须是锐角(毕竟锐角才是向下的),这样的方向叫做下降方向

下降方法算法

求解初期点x∈domf,k:=0\mathbf{x} \in \mathbf{dom}f, k := 0
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_{k})\parallel < \varepsilon
  2. 决定下降方向:Δd\Delta \mathbf{d}
  3. 直线探索,选择步长:t>0t > 0
  4. 计算下一个点:xk+1=xk+tkΔdk\mathbf{x}_{k+1} = \mathbf{x}_{k} + t_{k}\Delta \mathbf{d}_{k}
  5. k:=k+1k := k + 1

精确直线搜索

有时候我们会用一种叫做精确直线搜索的方法,其中tt是通过沿着射线{x+tΔd∣t≥0}\lbrace \mathbf{x} + t\Delta \mathbf{d} | t \geq 0 \rbrace优化ff而确定的

t=arg⁡min⁡s≥0f(x+sΔd)t = \arg{}\min_{s\geq 0} f(\mathbf{x} + s\Delta \mathbf{d})


考虑正定对称矩阵A∈Rn×nA \in \mathbb{R}^{n\times n},b∈Rn\mathbf{b} \in \mathbb{R}^n,求解二次型函数

minf(x)=12xTAx+bTxmin \quad f(\mathbf{x}) = \frac{1}{2}\mathbf{x}^TA\mathbf{x} + \mathbf{b}^T\mathbf{x}

根据下降方法的定义,函数将变为f(xk+sΔdk)f(\mathbf{x}_{k} + s\Delta \mathbf{d}_{k}),将这个形式写作ϕ(a)\phi(a)

ϕ(a)=f(xk+aΔdk)=12(xk+aΔdk)TA(xk+aΔdk)+bT(xk+aΔdk)=12(ΔdkTAΔdk)a2+(ΔdkT∇f(xk))a+f(xk)\begin{aligned} \phi(a) &= f(\mathbf{x}_k + a\Delta \mathbf{d}_k) \\ &= \frac{1}{2}(\mathbf{x}_k + a\Delta \mathbf{d}_k)^TA(\mathbf{x}_k + a\Delta \mathbf{d}_k) + \mathbf{b}^T(\mathbf{x}_k + a\Delta \mathbf{d}_k) \\ &= \frac{1}{2}(\Delta\mathbf{d}^T_kA\Delta\mathbf{d}_k)a^2 + (\Delta\mathbf{d}^T_k\nabla f(\mathbf{x}_k))a + f(\mathbf{x}_k) \end{aligned}

这是一个关于aa的二次函数,其中∇f(x)=Ax+b\nabla f(\mathbf{x}) = A\mathbf{x} + \mathbf{b},由于AA是正定矩阵,可以知道ΔdkTAΔdk>0\Delta\mathbf{d}^T_kA\Delta\mathbf{d}_k > 0,为了求得ϕ(a)\phi(a)的最小值,求得使ddaϕ(a)=0\frac{d}{da}\phi(a) = 0的aa即可

ddaϕ(a)=(ΔdkTAΔdk)a+ΔdkT∇f(xk)=0\frac{d}{da}\phi(a) = (\Delta\mathbf{d}^T_kA\Delta\mathbf{d}_k)a + \Delta\mathbf{d}^T_k \nabla f(\mathbf{x}_k) = 0

解得

ak=−ΔdkT∇f(xk)ΔdkTAΔdka_k = -\frac{\Delta\mathbf{d}^T_k \nabla f(\mathbf{x}_k)}{\Delta\mathbf{d}^T_kA\Delta\mathbf{d}_k}

这里ΔdkT∇f(xk)<0\Delta\mathbf{d}^T_k \nabla f(\mathbf{x}_k) < 0,所以ak>0a_k > 0

回溯直线搜索(Armijo条件)

实践中主要采用非精确直线搜索方法,因为实际中精确直线搜索一般无法使用,沿着射线{x+tΔd ∣ t≥0}\lbrace \mathbf{x} + t\Delta \mathbf{d}\ |\ t \geq 0 \rbrace优化ff确定步长,只要ff有足够的减少即可

回溯直线搜索算法

确定参数a∈(0,0.5),β∈(0,1),t=1,k:=0a \in (0, 0.5), \beta \in (0, 1), t = 1, k := 0
重复进行:

  1. 如果f(x+tΔd)>f(x)+at∇f(x)TΔdf(\mathbf{x} + t\Delta \mathbf{d}) > f(\mathbf{x}) + at\nabla f(\mathbf{x})^T\Delta \mathbf{d},则t:=βt,k:=k+1t := \beta t, k := k + 1
  2. 否则返回tt
回溯直线搜索收束性

由于Δd\Delta \mathbf{d}是降下方向,∇f(x)TΔd<0\nabla f(\mathbf{x})^T\Delta \mathbf{d} < 0,所以只要满足tt足够小,就一定有

f(x+tΔd)≈f(x)+t∇f(x)TΔd<f(x)+at∇f(x)TΔd\begin{aligned} f(\mathbf{x} + t\Delta \mathbf{d}) &\approx f(\mathbf{x}) + t\nabla f(\mathbf{x})^T\Delta \mathbf{d} \\ &< f(\mathbf{x}) + at\nabla f(\mathbf{x})^T\Delta \mathbf{d} \end{aligned}

因此回溯直线搜索方法最终会停止

  • 常数aa表示可以接受的ff的减少量占基于线性外推预测的减少量比值
  • aa需要小于0.50.5
    • 正常一般在0.01∼0.30.01 \sim 0.3之间,表示我们可以接受的ff的减少量在基于线性外推预测的减少量的1%1\%和30%30\%之间
  • β\beta正常取值:
    • 接近0.10.1:非常粗糙的搜索
    • 接近0.80.8:不太粗糙的搜索

Wolfe条件

Wolfe条件是在Armijo条件基础之上的条件。

Wolfe条件算法

确定参数0<a1<a2<0.5,β∈(0,1),t=1,k:=00 < a_1 < a_2 < 0.5, \beta \in (0, 1), t = 1, k := 0
重复进行:

  1. 如果

f(x+tΔd)>f(x)+a1t∇f(x)TΔda2∇f(x)TΔd>∇f(x+tΔd)TΔd\begin{aligned} f(\mathbf{x} + t\Delta \mathbf{d}) &> f(\mathbf{x}) + a_1t\nabla f(\mathbf{x})^T\Delta \mathbf{d} \\ a_2\nabla f(\mathbf{x})^T \Delta \mathbf{d} &> \nabla f(\mathbf{x} + t\Delta \mathbf{d})^T\Delta \mathbf{d} \end{aligned}

则t:=βt,k:=k+1t := \beta t, k := k + 1,否则返回tt

直线搜索方法的收敛性

为了获得全局最优解,我们需要得到

  • 搜索步径
  • 比例因子

其中最速下降方向−∇f(xk)-\nabla f(\mathbf{x}_{k})与搜索步径Δd\Delta \mathbf{d}的夹角为

cos⁡θk=−∇f(xk)TΔd∥−∇f(xk)∥⋅∥Δd∥\cos \theta_{k} = \frac{-\nabla f(\mathbf{x}_{k})^T\Delta \mathbf{d}}{\parallel-\nabla f(\mathbf{x}_{k})\parallel\cdot\parallel\Delta \mathbf{d}\parallel}

利普希茨连续条件(Zoutendijk条件)

假定函数ff是在Rn\mathbb{R}^n下有界,且在初始点x0\mathbf{x}_0的开集合N={x ∣ f(x)≤f(x0)N = \lbrace \mathbf{x}\ |\ f(\mathbf{x}) \leq f(\mathbf{x}_0)上连续可导,那么∀x,y∈N,∃L\forall \mathbf{x}, \mathbf{y} \in N, \exists L,使得

∥∇f(x)−∇f(y)∥≤L∥x−y∥\parallel \nabla f(\mathbf{x}) - \nabla f(\mathbf{y}) \parallel \leq L\parallel \mathbf{x} - \mathbf{y} \parallel

其中LL称为利普希茨定数,不等式称为利普希茨连续,当下降法,比例因子满足Wolfe条件的时候,其点阵xk,k=1,2,⋯\mathbf{x}_{k}, k =1,2,\cdots,满足以下不等式

∑k=0∞(∇f(xk)Tdk∥dk∥)2<∞\sum^\infty_{k=0}(\frac{\nabla f(\mathbf{x}_{k})^T \mathbf{d}_{k}}{\parallel \mathbf{d}_{k} \parallel})^2 < \infty

化简后得到Zoutendijk条件

∑k=0∞(∥∇f(xk)∥⋅cos⁡θk)2<∞\sum^\infty_{k=0}(\parallel\nabla f(\mathbf{x}_{k})\parallel\cdot\cos \theta_{k})^2 < \infty

由无限级数的收束条件可得

lim⁡k→∞∇f(xk)Tdk∥dk∥=0⇕lim⁡k→∞∥∇f(xk)T∥⋅cos⁡θk=0\begin{gathered} \lim_{k\rightarrow\infty}\frac{\nabla f(\mathbf{x}_{k})^T \mathbf{d}_{k}}{\parallel \mathbf{d}_{k} \parallel} = 0 \\ \Updownarrow \\ \lim_{k\rightarrow\infty} \parallel \nabla f(\mathbf{x}_{k})^T \parallel\cdot\cos \theta_{k} = 0 \end{gathered}

如果对于∀k\forall k,存在δ>0\delta > 0使得cos⁡θk≥δ\cos \theta_{k} \geq \delta,则

lim⁡k→∞∥∇f(xk)T∥=0\lim_{k\rightarrow\infty} \parallel \nabla f(\mathbf{x}_{k})^T \parallel = 0

上式展现了生成点阵的全局的收束性,也就是说,满足∀k\forall k,存在δ>0\delta > 0使得cos⁡θk≥δ\cos \theta_{k} \geq \delta的点阵xk,k=1,2,⋯\mathbf{x}_{k}, k =1,2,\cdots如果存在,则

lim inf⁡k→∞∥∇f(xk)T∥=0\liminf_{k\rightarrow\infty} \parallel \nabla f(\mathbf{x}_{k})^T \parallel = 0

梯度下降方法

goal∇f(x∗)=0,(x∗:local min)\begin{aligned} goal &\qquad \nabla f(\mathbf{x}^*) = 0, \quad (\mathbf{x}^*: local\ min) \end{aligned}

本算法用负梯度作搜索方向,即

Δdk=−∇f(xk)\Delta \mathbf{d}_k = -\nabla f(\mathbf{x}_k)

梯度下降方法算法

求解初期点x∈domf,k:=0\mathbf{x} \in \mathbf{dom}f, k := 0
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定下降方向:Δdk=−∇f(xk)\Delta \mathbf{d}_k = -\nabla f(\mathbf{x}_k)
  3. 通过精确或回溯直线探索,选择步长t>0t > 0
  4. 计算下一个点:xk+1=xk+tkΔdk\mathbf{x}_{k+1} = \mathbf{x}_k + t_k\Delta \mathbf{d}_k
  5. k:=k+1k := k + 1

梯度下降方法收敛性

// TODO

最速下降方法

对f(x+v)f(\mathbf{x} + \mathbf{v})在x\mathbf{x}处进行一阶泰拉展开

f(x+v)≈f^(x+v)=f(x)+∇f(x)Tvf(\mathbf{x} + \mathbf{v}) \approx \hat{f}(\mathbf{x} + \mathbf{v}) = f(\mathbf{x}) + \nabla f(\mathbf{x})^T \mathbf{v}

  • ∇f(x)Tv\nabla f(\mathbf{x})^T \mathbf{v}:是ff在x\mathbf{x}处沿方向v\mathbf{v}的方向导数
    • 近似给出了ff沿小的步径v\mathbf{v}会发生的变化
    • 如果方向导数是负数,则步径v\mathbf{v}是下降方向

如选择v\mathbf{v}使其方向导数尽可能小

  • 由于方向导数∇f(x)Tv\nabla f(\mathbf{x})^T \mathbf{v}是v\mathbf{v}的线性函数
    • v→+∞\mathbf{v} \rightarrow +\infty,则方向导数充分小
    • 为了使问题有意义,还必须限制v\mathbf{v}的大小

我们定义一个规范化的最速下降方向

Δdnsd=arg⁡min⁡{∇f(x)Tv ∣ ∥v∥=0}\Delta \mathbf{d}_{nsd} = \arg \min \lbrace \nabla f(\mathbf{x})^T\mathbf{v}\ |\ \parallel \mathbf{v} \parallel = 0\rbrace

  • 一个最速下降方向使因为上述优化问题可能有多个最优解
  • 一个规范化的最速下降方向Δdnsd\Delta \mathbf{d}_{nsd}是一个能使ff的线性近似下降最多的具有单位范数的步径

我们也可以把规范化的最速下降方向Δdnsd\Delta \mathbf{d}_{nsd}定义为

Δdnsd=arg⁡min⁡{∇f(x)Tv ∣ ∥v∥≤0}\Delta \mathbf{d}_{nsd} = \arg \min \lbrace \nabla f(\mathbf{x})^T\mathbf{v}\ |\ \parallel \mathbf{v} \parallel \leq 0\rbrace

  • 单位球体中在−∇f(x)-\nabla f(\mathbf{x})的方向上投影最长的方向

还可以将规范化的最速下降方向乘以一个特殊的比例因子,从而考虑下述非规范的最速下降方向Δdsd\Delta \mathbf{d}_{sd}

Δdsd=∥∇f(x)∥∗∇f(x)TΔdnsd=−∥∇f(x)∥∗2\begin{aligned} \Delta \mathbf{d}_{sd} &= \parallel \nabla f(\mathbf{x}) \parallel_* \nabla f(\mathbf{x})^T \Delta \mathbf{d}_{nsd} \\ &= -\parallel \nabla f(\mathbf{x}) \parallel^2_* \end{aligned}

最速下降方法使用最速下降方向作为直线搜索方向

最速下降方法算法

求解初期点x∈domf,k:=0\mathbf{x} \in \mathbf{dom}f, k := 0
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定下降方向:Δdsd\Delta \mathbf{d}_{sd}或者Δdnsd\Delta \mathbf{d}_{nsd}
  3. 通过精确或回溯直线探索,选择步长t>0t > 0
  4. 计算下一个点:xk+1=xk+tkΔdsd/nsd\mathbf{x}_{k+1} = \mathbf{x}_k + t_k\Delta \mathbf{d}_{sd/nsd}
  5. k:=k+1k := k + 1

如果采用精确直线搜索方向,下降方向的比例因子不起作用,因此规范化或非规范化的方向都能用

  • 采用Euclid范数:
    • Δdsd=−∇f(x)\Delta \mathbf{d}_{sd} = - \nabla f(\mathbf{x})
  • 采用二次范数:
    • Δdnsd=−(∇f(x)TP−1∇f(x))−1/2P−1∇f(x)\Delta \mathbf{d}_{nsd} = -(\nabla f(\mathbf{x})^TP^{-1}\nabla f(\mathbf{x}))^{-1/2}P^{-1}\nabla f(\mathbf{x})
    • Δdsd=−P−1∇f(x)\Delta \mathbf{d}_{sd} = -P^{-1}\nabla f(\mathbf{x})

最速下降方法收敛性

// TODO

牛顿法

牛顿法采用的是二阶近似,见二阶近似的最优解

牛顿步径

对于x∈domf\mathbf{x} \in \mathbf{dom} f,称向量

Δdnt=−∇2f(x)−1∇f(x)\Delta \mathbf{d}_{nt} = -\nabla^2f(\mathbf{x})^{-1}\nabla f(\mathbf{x})

为ff在x\mathbf{x}处的牛顿步径

  • 除非∇f(x)=0\nabla f(\mathbf{x}) = 0,从∇2f(x)\nabla^2f(\mathbf{x})的正当性可知∇f(x)TΔdnt\nabla f(\mathbf{x})^T\Delta \mathbf{d}_{nt}为下降方向

∇f(x)TΔdnt=−∇f(x)T∇2f(x)−1∇f(x)<0\nabla f(\mathbf{x})^T\Delta \mathbf{d}_{nt} = -\nabla f(\mathbf{x})^T\nabla^2f(\mathbf{x})^{-1}\nabla f(\mathbf{x}) < 0

牛顿法算法

求解初期点x∈domf,k:=0\mathbf{x} \in \mathbf{dom}f, k := 0
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定牛顿方向:Δdnt\Delta \mathbf{d}_{nt}
  3. 计算下一个点:xk+1=xk+Δdnt\mathbf{x}_{k+1} = \mathbf{x}_k + \Delta \mathbf{d}_{nt}
  4. k:=k+1k := k + 1

牛顿减量

对于原始牛顿法,由于没有比例因子,对于非二次型目标函数,有时会使函数值上升,表明原始牛顿法不能保证函数值稳定的下降,于是我们定义

λ(z)={(∇f(x)T∇2f(x)−1∇f(x))1/2or(ΔdntT∇2f(x)Δdnt)1/2\lambda(z) = \begin{cases} (\nabla f(\mathbf{x})^T \nabla^2 f(\mathbf{x})^{-1}\nabla f(\mathbf{x}))^{1/2} \\ or \\ (\Delta \mathbf{d}_{nt}^T \nabla^2 f(\mathbf{x})\Delta \mathbf{d}_{nt})^{1/2} \end{cases}

为x\mathbf{x}处的牛顿减量,我们可以将牛顿减量与二阶近似联系到一起

f(x)−inf⁡yf^(x)=f(x)−f^(x+Δdnt)=12λ(x)2f(\mathbf{x}) - \inf_y\hat{f}(\mathbf{x}) = f(\mathbf{x}) - \hat{f}(\mathbf{x} + \Delta \mathbf{d}_{nt}) = \frac{1}{2}\lambda (\mathbf{x})^2

另外牛顿减量也出现在回溯直线搜索中,即

∇f(x)TΔdnt=−λ(x)2\nabla f(\mathbf{x})^T \Delta \mathbf{d}_{nt} = -\lambda (\mathbf{x})^2

这是在回溯直线搜索中使用的常数,也可以解释为ff在x\mathbf{x}处沿牛顿步径方向的方向导数

−λ(x)2=∇f(x)TΔdnt=ddtf(x+Δdntt)∣t=0-\lambda(\mathbf{x})^2 = \nabla f(\mathbf{x})^T \Delta \mathbf{d}_{nt} = \frac{d}{dt}f(\mathbf{x} + \Delta \mathbf{d}_{nt}t)\Big |_{t=0}

阻尼牛顿法

在原始牛顿法的基础上,引入比例因子λ\lambda,也就是牛顿减量

λk=arg min⁡λ∈Rf(xk+λΔdnt)\lambda_k = \argmin_{\lambda \in \mathbb{R}}f(\mathbf{x}_k + \lambda\Delta \mathbf{d}_{nt})

阻尼牛顿法算法

求解初期点x∈domf,k:=0\mathbf{x} \in \mathbf{dom}f, k := 0

重复进行:

  1. 计算牛顿步径和减量
    1. λ2=∇f(x)T∇2f(x)−1∇f(x)\lambda^2 = \nabla f(\mathbf{x})^T \nabla^2 f(\mathbf{x})^{-1}\nabla f(\mathbf{x})
    2. Δdnt=−∇2f(x)−1∇f(x)\Delta \mathbf{d}_{nt} = -\nabla^2f(\mathbf{x})^{-1}\nabla f(\mathbf{x})
  2. 如果λ2/2≤ϵ\lambda^2/2 \leq \epsilon,则停止
  3. 通过回溯直线探索,选择步长t>0t > 0
  4. 计算下一个点:xk+1=xk+tΔdnt\mathbf{x}_{k+1} = \mathbf{x}_{k} + t\Delta \mathbf{d}_{nt}
  5. k:=k+1k := k + 1

拟牛顿法

在牛顿法的迭代中,需要计算Hessian矩阵

  • 此计算时间复杂度较大
  • 有时候Hessian矩阵不是正定矩阵

于是我们可以使用一个nn阶矩阵Gk=G(xk)G_k = G(\mathbf{x}_{k})来近似代替∇2f(x)−1\nabla^2 f(\mathbf{x})^{-1},且必须和∇2f(x)\nabla^2 f(\mathbf{x})由相同的性质即正定对称矩阵

由

f(x+Δd)=f(x)+∇f(x+tΔd)TΔd+12ΔdT∇2f(x+tΔd)Δdf(\mathbf{x} + \Delta \mathbf{d}) = f(\mathbf{x}) + \nabla f(\mathbf{x} + t\Delta \mathbf{d})^T\Delta \mathbf{d} + \frac{1}{2}\Delta \mathbf{d}^T\nabla^2f(\mathbf{x} + t\Delta \mathbf{d})\Delta \mathbf{d}

得到

f(x)≈f(xk+1)+∇f(xk+1)T(x−xk+1)+12(x−xk+1)T∇2f(xk+1)(x−xk+1)f(\mathbf{x} ) \approx f(\mathbf{x}_{k+1}) + \nabla f(\mathbf{x}_{k+1})^T(\mathbf{x} - \mathbf{x}_{k+1}) + \frac{1}{2}(\mathbf{x} - \mathbf{x}_{k+1})^T\nabla^2f(\mathbf{x}_{k+1})(\mathbf{x} - \mathbf{x}_{k+1})

此时,对两边取梯度

∇f(x)≈∇f(xk+1)+∇2f(xk+1)(x−xk+1)\nabla f(\mathbf{x}) \approx \nabla f(\mathbf{x}_{k+1}) + \nabla^2f(\mathbf{x}_{k+1})(\mathbf{x} - \mathbf{x}_{k+1})

取x=xk\mathbf{x} = \mathbf{x}_{k},化简可得

∇f(xk+1)−∇f(xk)≈∇2f(xk+1)(xk+1−xk)\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}) \approx \nabla^2f(\mathbf{x}_{k+1})(\mathbf{x}_{k+1} - \mathbf{x}_{k})

上述就是拟牛顿法,当我们对∇2f(xk+1)\nabla^2f(\mathbf{x}_{k+1})做近似Bk+1B_{k+1},即可得到

∇f(xk+1)−∇f(xk)≈Bk+1(xk+1−xk)\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}) \approx B_{k+1}(\mathbf{x}_{k+1} - \mathbf{x}_{k})

拟牛顿法(DFP)

该算法通过对迭代的方法,对∇2f(xk+1)−1\nabla^2f(\mathbf{x}_{k+1})^{-1}做近似,其格式为

Dk+1=Dk+ΔDk,k=0,1,2,⋯D_{k+1} = D_{k} + \Delta D_{k}, \quad k = 0,1,2,\cdots

其中D0D_{0}一般取单位矩阵II,我们将ΔDk\Delta D_{k}待定为

ΔDk=auuT+βvvT\Delta D_{k} = a\mathbf{u}\mathbf{u}^T + \beta \mathbf{v}\mathbf{v}^T

其中a,βa, \beta为待定系数,u,v\mathbf{u}, \mathbf{v}为待定向量,这种形式保证了矩阵的对称性,我们将其带入式子中

xk+1−xk=(Dk+ΔDk)(∇f(xk+1)−∇f(xk))=(Dk−auuT+βvvT)(∇f(xk+1)−∇f(xk))\begin{aligned} \mathbf{x}_{k+1} - \mathbf{x}_{k} &= (D_{k} + \Delta D_{k})(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) \\ &= (D_{k} - a\mathbf{u}\mathbf{u}^T + \beta \mathbf{v}\mathbf{v}^T)(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) \end{aligned}

其中注意到以下式子,我们进行以下的赋值

{auT(∇f(xk+1)−∇f(xk))=1βvT(∇f(xk+1)−∇f(xk))=−1\begin{cases} a\mathbf{u}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) = 1 \\ \beta \mathbf{v}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) = -1 \end{cases}

得到

{a=1uT(∇f(xk+1)−∇f(xk))β=−1vT(∇f(xk+1)−∇f(xk))\begin{cases} a = \frac{1}{\mathbf{u}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \\ \beta = \frac{-1}{\mathbf{v}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \end{cases}

我们再将上面的式子代回去,可以得到

u−v=(xk+1−xk)−Dk(∇f(xk+1)−∇f(xk))\mathbf{u} - \mathbf{v} = (\mathbf{x}_{k+1} - \mathbf{x}_{k}) - D_{k}(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))

为了使上式成立,我们可以取

{u=(xk+1−xk)v=Dk(∇f(xk+1)−∇f(xk))\begin{cases} \mathbf{u} = (\mathbf{x}_{k+1} - \mathbf{x}_{k}) \\ \mathbf{v} = D_{k}(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) \end{cases}

再将此带入到a,βa, \beta进行求值

a=1(xk+1−xk)T(∇f(xk+1)−∇f(xk))β=−1(∇f(xk+1)−∇f(xk))T⋅Dk⋅(∇f(xk+1)−∇f(xk))\begin{aligned} a &= \frac{1}{(\mathbf{x}_{k+1} - \mathbf{x}_{k})^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \\ \beta &= \frac{-1}{(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))^T \cdot D_{k} \cdot (\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \end{aligned}

令s=xk+1−xk,y=∇f(xk+1)−∇f(xk)\mathbf{s} = \mathbf{x}_{k+1} - \mathbf{x}_{k}, \mathbf{y} = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}),得到

∇Dk+1=skskTskTyk−Dkyk(Dkyk)TykTDkyk\nabla D_{k+1} = \frac{\mathbf{s}_k\mathbf{s}^T_k}{\mathbf{s}^T_k\mathbf{y}_k} - \frac{D_{k}\mathbf{y}_k(D_{k}\mathbf{y}_k)^T}{\mathbf{y}_k^TD_{k}\mathbf{y}_k}

DFP算法

求解初期点x∈domf,k:=0,D0=I\mathbf{x} \in \mathbf{dom}f, k := 0, D_{0} = I
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定下降方向:Δdnt=−Dk∇f(xk)\Delta \mathbf{d}_{nt} = -D_{k} \nabla f(\mathbf{x}_{k})
  3. 计算比例因子
    1. 利用直线搜索得到步长:λk\lambda_k
    2. 令sk=λkΔdnt\mathbf{s}_k = \lambda_k\Delta\mathbf{d}_{nt}
    3. 计算下一个点:xk+1=xk+sk\mathbf{x}_{k+1} = \mathbf{x}_k + \mathbf{s}_k
  4. 令yk=∇f(xk+1)−∇f(xk)\mathbf{y}_k = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})
  5. 计算Dk+1=Dk+skskTskTyk−DkykykTDkykTDkykD_{k+1} = D_{k} + \frac{\mathbf{s}_k\mathbf{s}^T_k}{\mathbf{s}^T_k\mathbf{y}_k} - \frac{D_{k}\mathbf{y}_k\mathbf{y}_k^TD_{k}}{\mathbf{y}_k^TD_{k}\mathbf{y}_k}
  6. k:=k+1k := k + 1

拟牛顿法(BFGS)

BFGS算法与DFP算法完全类似,只是把s,y\mathbf{s}, \mathbf{y}的位置进行了对调

Bk+1=Bk+ΔBk,k=0,1,2,⋯B_{k+1} = B_{k} + \Delta B_{k}, \quad k = 0,1,2,\cdots

其中B0B_{0}一般取单位矩阵II,我们将ΔBk\Delta B_{k}待定为

ΔBk=auuT+βvvT\Delta B_{k} = a\mathbf{u}\mathbf{u}^T + \beta \mathbf{v}\mathbf{v}^T

其中a,βa, \beta为待定系数,u,v\mathbf{u}, \mathbf{v}为待定向量,这种形式保证了矩阵的对称性,我们将其带入式子中

∇f(xk+1)−∇f(xk)=(Bk+ΔBk)(xk+1−xk)=(Bk−auuT+βvvT)(xk+1−xk)\begin{aligned} \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}) &= (B_{k} + \Delta B_{k})(\mathbf{x}_{k+1} - \mathbf{x}_{k}) \\ &= (B_{k} - a\mathbf{u}\mathbf{u}^T + \beta \mathbf{v}\mathbf{v}^T)(\mathbf{x}_{k+1} - \mathbf{x}_{k}) \end{aligned}

我们进行以下的赋值

{auT(∇f(xk+1)−∇f(xk))=1βvT(∇f(xk+1)−∇f(xk))=−1\begin{cases} a\mathbf{u}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) = 1 \\ \beta \mathbf{v}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) = -1 \end{cases}

得到

{a=1uT(∇f(xk+1)−∇f(xk))β=−1vT(∇f(xk+1)−∇f(xk))\begin{cases} a = \frac{1}{\mathbf{u}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \\ \beta = \frac{-1}{\mathbf{v}^T(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))} \end{cases}

我们再将上面的式子代回去,可以得到

u−v=(∇f(xk+1)−∇f(xk))−Bk(xk+1−xk)\mathbf{u} - \mathbf{v} = (\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})) - B_{k}(\mathbf{x}_{k+1} - \mathbf{x}_{k})

为了使上式成立,我们可以取

{u=∇f(xk+1)−∇f(xk)v=Bk(xk+1−xk)\begin{cases} \mathbf{u} = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}) \\ \mathbf{v} = B_{k}(\mathbf{x}_{k+1} - \mathbf{x}_{k}) \end{cases}

再将此带入到a,βa, \beta进行求值

a=1(∇f(xk+1)−∇f(xk))T(xk+1−xk)β=−1(xk+1−xk)T⋅Bk⋅(xk+1−xk)\begin{aligned} a &= \frac{1}{(\nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}))^T(\mathbf{x}_{k+1} - \mathbf{x}_{k})} \\ \beta &= \frac{-1}{(\mathbf{x}_{k+1} - \mathbf{x}_{k})^T \cdot B_{k} \cdot (\mathbf{x}_{k+1} - \mathbf{x}_{k})} \end{aligned}

令s=xk+1−xk,y=∇f(xk+1)−∇f(xk)\mathbf{s} = \mathbf{x}_{k+1} - \mathbf{x}_{k}, \mathbf{y} = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k}),得到

∇Bk=ykykTykTsk−Bksk(Bksk)TskTBksk\nabla B_{k} = \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k} - \frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k}

BFGS算法

求解初期点x∈domf,k:=0,B0=I\mathbf{x} \in \mathbf{dom}f, k := 0, B_{0} = I
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定下降方向:Δdnt=−(Bk)−1∇f(xk)\Delta \mathbf{d}_{nt} = -(B_{k})^{-1} \nabla f(\mathbf{x}_{k})
  3. 计算比例因子
    1. 利用直线搜索得到步长:λk\lambda_k
    2. 令sk=λkΔdnt\mathbf{s}_k = \lambda_k\Delta\mathbf{d}_{nt}
    3. 计算下一个点:xk+1=xk+sk\mathbf{x}_{k+1} = \mathbf{x}_k + \mathbf{s}_k
  4. 令yk=∇f(xk+1)−∇f(xk)\mathbf{y}_k = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})
  5. 计算Bk+1=Bk+ykykTykTsk−Bksk(Bksk)TskTBkskB_{k+1} = B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k} - \frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k}
  6. k:=k+1k := k + 1

Sherman-Morrison公式

这是线性代数中,这是求解逆矩阵的一种方法
设A∈Rn×n\mathbf{A} \in \mathbb{R}^{n \times n}为可逆矩阵,u,v\mathbf{u}, \mathbf{v}为列向量,则当

{vTA−1u≠−1uTv≠−1\begin{cases} \mathbf{v}^TA^{-1}\mathbf{u} \neq -1 \\ \mathbf{u}^T\mathbf{v} \neq -1 \end{cases}

则

(A+uvT)−1=A−1−A−1vvTA−11+vTA−1u(A + \mathbf{u}\mathbf{v}^T)^{-1} = A^{-1} - \frac{A^{-1}\mathbf{v}\mathbf{v}^TA^{-1}}{1 + \mathbf{v}^TA^{-1}\mathbf{u}}

证明:

令X=A+uvT,Y=A−1−A−1uvTA−11+vTA−1uX=A+\mathbf{u}\mathbf{v}^{T}, Y= A^{-1}- \frac{A^{-1}\mathbf{u}\mathbf{v}^{T}A^{-1}}{1+\mathbf{v}^{T}A^{-1}\mathbf{u}}

XY=(A+uvT)(A−1−A−1uvTA−11+vTA−1u)=AA−1+uvTA−1−AA−1uvTA−1+uvTA−1uvTA−11+vTA−1u=I+uvTA−1−uvTA−1+uvTA−1uvTA−11+vTA−1u=I+uvTA−1−u(1+vTA−1u)vTA−11+vTA−1u=I+uvTA−1−uvTA−1=I\begin{aligned} XY&=(A+\mathbf{u}\mathbf{v}^{T})\left(A^{-1}-\frac{A^{-1}\mathbf{u}\mathbf{v}^{T}A^{-1}}{1+\mathbf{v}^{T}A^{-1}\mathbf{u}}\right)\\ &=AA^{-1}+\mathbf{u}\mathbf{v}^{T}A^{-1}-\frac{AA^{-1}\mathbf{u}\mathbf{v}^{T}A^{-1}+\mathbf{u}\mathbf{v}^{T}A^{-1}\mathbf{u}\mathbf{v}^{T}A^{-1}}{1+\mathbf{v}^{T}A^{-1}\mathbf{u}}\\ &=I+\mathbf{u}\mathbf{v}^{T}A^{-1}-\frac{\mathbf{u}\mathbf{v}^{T}A^{-1}+\mathbf{u}\mathbf{v}^{T}A^{-1}\mathbf{u}\mathbf{v}^{T}A^{-1}}{1+\mathbf{v}^{T}A^{-1}\mathbf{u}}\\ &=I+\mathbf{u}\mathbf{v}^{T}A^{-1}-\frac{\mathbf{u}(1+\mathbf{v}^{T}A^{-1}\mathbf{u})\mathbf{v}^{T}A^{-1}}{1+\mathbf{v}^{T}A^{-1}\mathbf{u}}\\ &=I+\mathbf{u}\mathbf{v}^{T}A^{-1}-\mathbf{u}\mathbf{v}^{T}A^{-1}\\ &=I\end{aligned}

Sherman-Morrison公式应用
  • A=IA = I

令A=IA=I,则有I+uvTI + \mathbf{u}\mathbf{v}^T可逆当且仅当vTu=−1\mathbf{v}^T\mathbf{u} = -1

(I+uvT)−1=I−uvT1+vTu(I + \mathbf{u}\mathbf{v}^T)^{-1} = I - \frac{\mathbf{u}\mathbf{v}^T}{1 + \mathbf{v}^T\mathbf{u}}

若v=u\mathbf{v} = \mathbf{u},则1+uTu>01 + \mathbf{u}^T\mathbf{u} > 0,所以I+uuTI + \mathbf{u}\mathbf{u}^T可逆

(I+uuT)−1=I−uuT1+uTu(I + \mathbf{u}\mathbf{u}^T)^{-1} = I - \frac{\mathbf{u}\mathbf{u}^T}{1 + \mathbf{u}^T\mathbf{u}}

拟牛顿法(H-BFGS)

还可以通过近似Hessian逆矩阵,进一步优化BFGS方法

Bk+1=Bk+ΔBk=Bk+ykykTykTsk−Bksk(Bksk)TskTBkskBk+1−1=((Bk+ykykTykTsk)−Bksk(Bksk)TskTBksk)−1=(Bk+ykykTykTsk)−1−(Bk+ykykTykTsk)−1(−Bksk(Bksk)TskTBksk)(Bk+ykykTykTsk)−11+−(Bksk)T(Bk+ykykTykTsk)−1(Bksk)skTBksk=(Bk+ykykTykTsk)−1+(Bk+ykykTykTsk)−1Bksk(Bksk)TskTBksk−(Bksk)T(Bk+ykykTykTsk)−1(Bksk)(Bk+ykykTykTsk)−1\begin{aligned} B_{k+1} &= B_{k} + \Delta B_{k} \\ &= \color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black} - \frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k} \\ B^{-1}_{k+1} &= \Big ((\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black}) - \frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k} \Big )^{-1} \\ &= (\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1} - \frac{(\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1}(-\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k})(\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1}}{1 + \frac{-(B_{k}\mathbf{s}_k)^T(\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1}(B_{k}\mathbf{s}_k)}{\mathbf{s}_k^TB_{k}\mathbf{s}_k}} \\ &= (\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1} + (\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1}\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1}(B_{k}\mathbf{s}_k)}(\color{purple}{B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}}\color{black})^{-1} \end{aligned}

令(Bk+ykykTykTsk)=H(B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k}) = H,化简得到

Bk+1−1=H−1+H−1Bksk(Bksk)TskTBksk−(Bksk)T(H−1)(Bksk)H−1B^{-1}_{k+1} = H^{-1} + H^{-1}\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(H^{-1})(B_{k}\mathbf{s}_k)}H^{-1}

我们再来看看H=(Bk+ykykTykTsk)H = (B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k})

H−1=(Bk+ykykTykTsk)−1=Bk−1−B−1yyTyTsB−11+1yTsyTB−1y=Bk−1−B−1yyTB−1yTs+yTB−1y\begin{aligned} H^{-1} &= (B_{k} + \frac{\mathbf{y}_k\mathbf{y}^T_k}{\mathbf{y}^T_k\mathbf{s}_k})^{-1} \\ &= B^{-1}_k - \frac{B^{-1}\frac{\mathbf{y}\mathbf{y}^T}{\mathbf{y}^T\mathbf{s}}B^{-1}}{1 + \frac{1}{\mathbf{y}^T\mathbf{s}}\mathbf{y}^TB^{-1}\mathbf{y}} \\ &= B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}} \end{aligned}

我们现在关注H−1Bksk(Bksk)TskTBksk−(Bksk)T(H−1)(Bksk)H−1H^{-1}\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(H^{-1})(B_{k}\mathbf{s}_k)}H^{-1}

H−1Bksk(Bksk)TskTBksk−(Bksk)T(H−1)(Bksk)H−1=(Bk−1−B−1yyTB−1yTs+yTB−1y)Bksk(Bksk)TskTBksk−(Bksk)T(Bk−1−B−1yyTB−1yTs+yTB−1y)(Bksk)(Bk−1−B−1yyTB−1yTs+yTB−1y)=(Bk−1−B−1yyTB−1yTs+yTB−1y)Bksk(Bksk)TskTBksk−skTBksk+sTyyTsyTs+yTB−1y(Bk−1−B−1yyTB−1yTs+yTB−1y)=yTs+yTB−1ysTyyTs(Bk−1−B−1yyTB−1yTs+yTB−1y)BssTB(Bk−1−B−1yyTB−1yTs+yTB−1y)=yTs+yTB−1ysTyyTs(ssTB−B−1yyTB−1yTs+yTB−1y)(Bk−1−B−1yyTB−1yTs+yTB−1y)=yTs+yTB−1ysTyyTs(ssT−ssTyyTB−1yTs+yTB−1y−B−1yyTssTyTs+yTB−1y+B−1yyTssTyyTB−1(yTs+yTB−1y)2)=(yTs+yTB−1y)ssTsTyyTs−ssTyyTB−1sTyyTs−B−1yyTssTsTyyTs+B−1yyTssTyyTB−1(yTs+yTB−1y)sTyyTs=(yTs+yTB−1y)ssTsTyyTs−syTB−1sTy−B−1ysTsTy+B−1yyTB−1yTs+yTB−1y\begin{aligned} &H^{-1}\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(H^{-1})(B_{k}\mathbf{s}_k)}H^{-1} \\ =& (B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}})\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}})(B_{k}\mathbf{s}_k)}(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}) \\ =& (B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}})\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k - \mathbf{s}_k^TB_{k}\mathbf{s}_k + \frac{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}}(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}) \\ =& \frac{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}}(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}})B\mathbf{s}\mathbf{s}^TB(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}) \\ =& \frac{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}}(\mathbf{s}\mathbf{s}^TB - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}})(B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}) \\ =& \frac{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}}(\mathbf{s}\mathbf{s}^T - \frac{\mathbf{s}\mathbf{s}^T\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} - \frac{B^{-1}\mathbf{y}\mathbf{y}^T\mathbf{s}\mathbf{s}^T}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} + \frac{B^{-1}\mathbf{y}\mathbf{y}^T\mathbf{s}\mathbf{s}^T\mathbf{y}\mathbf{y}^TB^{-1}}{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})^2}) \\ =& \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}} - \frac{\mathbf{s}\mathbf{s}^T\mathbf{y}\mathbf{y}^TB^{-1}}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}} - \frac{B^{-1}\mathbf{y}\mathbf{y}^T\mathbf{s}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}} + \frac{B^{-1}\mathbf{y}\mathbf{y}^T\mathbf{s}\mathbf{s}^T\mathbf{y}\mathbf{y}^TB^{-1}}{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}} \\ =& \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}\mathbf{y}^T\mathbf{s}} - \frac{\mathbf{s}\mathbf{y}^TB^{-1}}{\mathbf{s}^T\mathbf{y}} - \frac{B^{-1}\mathbf{y}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}} + \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} \end{aligned}

于是

Bk+1−1=H−1+H−1Bksk(Bksk)TskTBksk−(Bksk)T(H−1)(Bksk)H−1=H−1+(yTs+yTB−1y)ssTsTyyTs−syTB−1sTy−B−1ysTsTy+B−1yyTB−1yTs+yTB−1y=Bk−1−B−1yyTB−1yTs+yTB−1y+(yTs+yTB−1y)ssTsTyyTs−syTB−1sTy−B−1ysTsTy+B−1yyTB−1yTs+yTB−1y=Bk−1+(yTs+yTB−1y)ssTsTyyTs−syTB−1sTy−B−1ysTsTy=(I−syTsTy)B−1−B−1ysTsTy+(yTs+yTB−1y)ssT(sTy)2=(I−syTsTy)B−1−(I−syTsTy)B−1ysTsTy+ssTsTy=(I−syTsTy)B−1(I−ysTsTy)+ssTsTy\begin{aligned} B^{-1}_{k+1} &= H^{-1} + H^{-1}\frac{B_{k}\mathbf{s}_k(B_{k}\mathbf{s}_k)^T}{\mathbf{s}_k^TB_{k}\mathbf{s}_k-(B_{k}\mathbf{s}_k)^T(H^{-1})(B_{k}\mathbf{s}_k)}H^{-1} \\ &= H^{-1} + \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}\mathbf{y}^T\mathbf{s}} - \frac{\mathbf{s}\mathbf{y}^TB^{-1}}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} - \frac{B^{-1}\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} + \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} \\ &= B^{-1}_k - \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} + \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}\mathbf{y}^T\mathbf{s}} - \frac{\mathbf{s}\mathbf{y}^TB^{-1}}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} - \frac{B^{-1}\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} + \frac{B^{-1}\mathbf{y}\mathbf{y}^TB^{-1}}{\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black}} \\ &= B^{-1}_k + \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}\mathbf{y}^T\mathbf{s}} - \frac{\mathbf{s}\mathbf{y}^TB^{-1}}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} - \frac{B^{-1}\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} \\ &=(I - \frac{\mathbf{s}\mathbf{y}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}})B^{-1}-B^{-1}\frac{\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} + \frac{(\color{purple}{\mathbf{y}^T\mathbf{s} + \mathbf{y}^TB^{-1}\mathbf{y}}\color{black})\mathbf{s}\mathbf{s}^T}{(\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black})^2} \\ &=(I - \frac{\mathbf{s}\mathbf{y}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}})B^{-1}-(I - \frac{\mathbf{s}\mathbf{y}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}})B^{-1}\frac{\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} + \frac{\mathbf{s}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} \\ &=(I - \frac{\mathbf{s}\mathbf{y}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}})B^{-1}(I - \frac{\mathbf{y}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}}) + \frac{\mathbf{s}\mathbf{s}^T}{\color{blue}{\mathbf{s}^T\mathbf{y}}\color{black}} \end{aligned}

通过使用2次公式,最终得到

Bk+1−1=(I−syTsTy)B−1(I−ysTsTy)+ssTsTyB^{-1}_{k+1} = (I - \frac{\mathbf{s}\mathbf{y}^T}{\mathbf{s}^T\mathbf{y}})B^{-1}(I - \frac{\mathbf{y}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}}) + \frac{\mathbf{s}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}}

H-BFGS算法

求解初期点x∈domf,k:=0,D0=I\mathbf{x} \in \mathbf{dom}f, k := 0, D_{0} = I
重复进行:

  1. 停止条件:∥∇f(xk)∥<ε\parallel\nabla f(\mathbf{x}_k)\parallel < \varepsilon
  2. 决定下降方向:Δdnt=−Bk−1∇f(xk)\Delta \mathbf{d}_{nt} = -B^{-1}_k \nabla f(\mathbf{x}_{k})
  3. 计算比例因子
    1. 利用直线搜索得到步长λk\lambda_k
    2. 令sk=λkΔdnt\mathbf{s}_k = \lambda_k\Delta\mathbf{d}_{nt}
    3. 计算下一个点:xk+1=xk+sk\mathbf{x}_{k+1} = \mathbf{x}_k + \mathbf{s}_k
  4. 令yk=∇f(xk+1)−∇f(xk)\mathbf{y}_k = \nabla f(\mathbf{x}_{k+1}) - \nabla f(\mathbf{x}_{k})
  5. 计算Bk+1−1=(I−syTsTy)B−1(I−ysTsTy)+ssTsTyB^{-1}_{k+1} = (I - \frac{\mathbf{s}\mathbf{y}^T}{\mathbf{s}^T\mathbf{y}})B^{-1}(I - \frac{\mathbf{y}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}}) + \frac{\mathbf{s}\mathbf{s}^T}{\mathbf{s}^T\mathbf{y}}
  6. k:=k+1k := k + 1

约束优化问题

一阶约束优化问题的本质是在梯度的下降方向上,沿着约束的方向进行优化,最后达到与约束条件的梯度相同的一点,即局部最优点,然后利用凸函数的性质,即可得到全局最优点,

等式约束条件

拉格朗日乘数法

求定义域内约束在某个区域内函数的极值, 可使用Lagrange乘子法

minz=f(x,y)s.t.φ(x,y)=0\begin{aligned} min &\qquad z = f(x, y) \\ s.t. &\qquad \varphi(x, y) = 0 \end{aligned}

我们假定在(x0,y0)(x_0, y_0)的某一领域内f(x,y)f(x, y)与φ(x,y)\varphi(x, y)均有连续的一阶偏导数,而φy(x0,y0)≠0\varphi_y(x_0, y_0) \neq 0,由隐函数存在定理可知,φ(x0,y0)=0\varphi(x_0, y_0) = 0确定一个连续且具有连续偏导数的函数y=ψ(x)y = \psi(x),将其带入后,得到

z=f(x,ψ(x))z = f(x, \psi(x))

于是原函数在(x0,y0)(x_0, y_0)处所求的极值,变为函数z=f(x,ψ(x))z = f(x, \psi(x))在x=x0x = x_0处取得的极值,由一元可导函数取得极值的必要条件可得

dzdx∣x=x0=fx(x0,y0)+fy(x0,y0)dydx∣x=x0=0\frac{dz}{dx}|_{x = x_0} = f_x(x_0, y_0) + f_y(x_0, y_0)\frac{dy}{dx}|_{x = x_0} = 0

由隐函数求导公式,得

dydx∣x=x0=−φx(x0,y0)φy(x0,y0)\frac{dy}{dx}|_{x=x_0} = -\frac{\varphi_x(x_0, y_0)}{\varphi_y(x_0, y_0)}

代入后得到

fx(x0,y0)−fy(x0,y0)φx(x0,y0)φy(x0,y0)=0f_x(x_0, y_0) - f_y(x_0, y_0)\frac{\varphi_x(x_0, y_0)}{\varphi_y(x_0, y_0)} = 0

设fy(x0,y0)φy(x0,y0)=−λ\frac{f_y(x_0, y_0)}{\varphi_y(x_0, y_0)} = -\lambda,上述条件变为

{fx(x0,y0)+λφx(x0,y0)=0fy(x0,y0)+λφy(x0,y0)=0φ(x0,y0)=0\begin{cases} f_x(x_0, y_0) + \lambda\varphi_x(x_0, y_0) = 0 \\ f_y(x_0, y_0) + \lambda\varphi_y(x_0, y_0) = 0 \\ \varphi(x_0, y_0) = 0 \end{cases}

上述条件可以看作在点(局部最小点)(x0,y0)(x_0, y_0)的ff的梯度的方向与φ\varphi的梯度方向同线,且满足φ(x0,y0)=0\varphi(x_0, y_0) = 0

引进辅助函数(拉格朗日函数)

L(x,y)=f(x,y)+λφ(x,y)L(x, y) = f(x, y) + \lambda\varphi(x, y)

可以看出

Lx(x,y)=fx(x0,y0)+λφx(x0,y0)=0Ly(x,y)=fy(x0,y0)+λφy(x0,y0)=0\begin{aligned} L_x(x, y) &= f_x(x_0, y_0) + \lambda\varphi_x(x_0, y_0) = 0 \\ L_y(x, y) &= f_y(x_0, y_0) + \lambda\varphi_y(x_0, y_0) = 0 \end{aligned}

将L(x,y)L(x, y)称为拉格朗日函数,参数λ\lambda称为拉格朗日乘子

拉格朗日乘数法算法
  • 先作拉格朗日函数

L(x,y)=f(x,y)+λφ(x,y)L(x, y) = f(x, y) + \lambda\varphi(x, y)

  • 分别求对x,yx, y的一阶偏导数,使之为0,然后与所有方程进行联立

{fx(x,y)+λφx(x,y)=0fy(x,y)+λφy(x,y)=0φ(x,y)=0\begin{cases} f_x(x, y) + \lambda\varphi_x(x, y) = 0 \\ f_y(x, y) + \lambda\varphi_y(x, y) = 0 \\ \varphi(x, y) = 0 \end{cases}

由上述方程解出x,y,λx, y, \lambda,这样得到的(x,y)(x, y)就是函数f(x,y)f(x, y)在附加条件φ(x,y)=0\varphi(x, y) = 0下可能的极值点

拉格朗日乘数法算法推广

minu=f(x,y,z,t)s.t.φ(x,y,z,t)=0ϕ(x,y,z,t)=0\begin{aligned} min &\qquad u = f(x, y, z, t) \\ s.t. &\qquad \varphi(x, y, z, t) = 0 \\ &\qquad \phi(x, y, z, t) = 0 \end{aligned}

  • 先作拉格朗日函数

L(x,y,z,t)=f(x,y,z,t)+λφ(x,y,z,t)+μϕ(x,y,z,t)\begin{aligned} L(x, y, z, t) = &f(x, y, z, t) \\ &+ \lambda\varphi(x, y, z, t) \\ &+ \mu\phi(x, y, z, t) \end{aligned}

其中λ,μ\lambda, \mu均为参数,求其一阶偏导数,并使之等于0,与原条件连理起来即可求解,即

{fx(x,y,z,t)+λφx(x,y,z,t)+μϕx(x,y,z,t)=0fy(x,y,z,t)+λφy(x,y,z,t)+μϕy(x,y,z,t)=0fz(x,y,z,t)+λφz(x,y,z,t)+μϕz(x,y,z,t)=0ft(x,y,z,t)+λφt(x,y,z,t)+μϕt(x,y,z,t)=0φ(x,y,z,t)=0ϕ(x,y,z,t)=0\begin{cases} f_x(x, y, z, t) + \lambda\varphi_x(x, y, z, t) + \mu\phi_x(x, y, z, t)= 0 \\ f_y(x, y, z, t) + \lambda\varphi_y(x, y, z, t) + \mu\phi_y(x, y, z, t)= 0 \\ f_z(x, y, z, t) + \lambda\varphi_z(x, y, z, t) + \mu\phi_z(x, y, z, t)= 0 \\ f_t(x, y, z, t) + \lambda\varphi_t(x, y, z, t) + \mu\phi_t(x, y, z, t)= 0 \\ \varphi(x, y, z, t) = 0 \\ \phi(x, y, z, t) = 0 \end{cases}

求解后得出的(x,y,z,t)(x, y, z, t)就是函数f(x,y,z,t)f(x, y, z, t)在附加条件下的可能极值点,至于是否为真正的极值点,需要在实际问题中根据问题本身的性质来判定

拉格朗日乘数法算法总结

minf(x)s.t.hi(x)=0,i=1,2,⋯ ,n\begin{aligned} min &\qquad f(\mathbf{x}) \\ s.t. &\qquad h_i(\mathbf{x}) = 0, \quad i = 1, 2, \cdots, n \end{aligned}

拉格朗日函数

L(x,λ)=f(x)+∑i=1nλihi(x),i=1,2,⋯ ,nL(\mathbf{x}, \lambda) = f(\mathbf{x}) + \sum^n_{i=1}\lambda_ih_i(\mathbf{x}), \quad i = 1, 2, \cdots, n

对其求导

Lxi(x,λ)=fxi(x)+∑i=1nλihixi(x),i=1,2,⋯ ,nL_{x_i}(\mathbf{x}, \lambda) = f_{x_i}(\mathbf{x}) + \sum^n_{i=1}\lambda_ih_{i_{x_i}}(\mathbf{x}), \quad i = 1, 2, \cdots, n

联立原条件方程后即可得到解

Lxi(x,λ)=fxi(x)+∑i=1nλihixi(x)hi(x)=0i=1,2,⋯ ,n\begin{aligned} &L_{x_i}(\mathbf{x}, \lambda) = f_{x_i}(\mathbf{x}) + \sum^n_{i=1}\lambda_ih_{i_{x_i}}(\mathbf{x}) \\ &h_i(\mathbf{x}) = 0 \\ &i = 1, 2, \cdots, n \end{aligned}

不等式约束条件

不等式约束问题的一阶最优性条件

考虑下方非线性规划问题

minf(x)s.t.gi(x)>0,i=1,2,⋯ ,m\begin{aligned} min &\qquad f(\mathbf{x}) \\ s.t. &\qquad g_i(\mathbf{x}) > 0, \quad i = 1, 2, \cdots, m \end{aligned}

这个问题的可行域为

S={x∣gi(x)≥0,i=1,2,⋯ ,m}S = \lbrace \mathbf{x} | g_i(\mathbf{x}) \geq 0, i = 1, 2, \cdots, m \rbrace

对于x‾∈S\overline{\mathbf{x}} \in S,将约束条件gi(x)g_i(\mathbf{x})分为以下2中情况(其他II为下标集,即下标的集合)

I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace

  • gi(x‾)=0,i∈Ig_i(\overline{\mathbf{x}}) = 0, i \in I

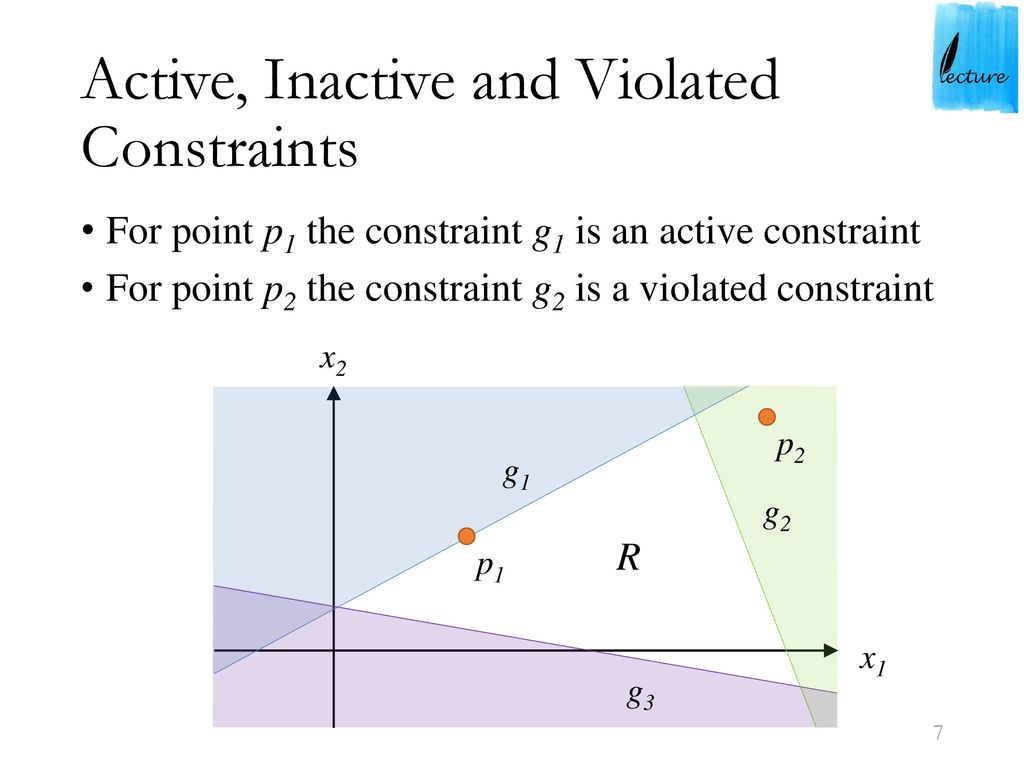
满足等号的等式,在x‾\overline{\mathbf{x}}的附近限制了可行点的范围,也就是在某些方向稍微移动一点,仍能满足约束条件,但是沿着另外一些方向,无论移动多少,也会违背约束条件,通俗的说就是在边界上。这样的约束条件称为在x‾\overline{\mathbf{x}}处起作用的约束

  • gi(x‾)>0,i∉Ig_i(\overline{\mathbf{x}}) > 0, i \notin I

反之,对于大于号的不等式,在x‾\overline{\mathbf{x}}的附近无论哪个方向,稍微离开一些距离都不会违背约束,通俗的说就是在不在边界上。这样的约束条件称为在x‾\overline{\mathbf{x}}处不起作用的约束

可以用集合

G0={d∣∇gi(x‾)Td>0,i∈I}G_0 = \lbrace \mathbf{d} | \nabla g_i(\overline{\mathbf{x}})^T\mathbf{d} > 0, i \in I \rbrace

取代可行域。

定理:设x‾∈S,f(x)\overline{\mathbf{x}} \in S, f(\mathbf{x})和gi(x)(i∈I)g_i(\mathbf{x})(i \in I)在x‾\overline{\mathbf{x}}可微,gi(x)(i∉I)g_i(\mathbf{x})(i \notin I)在x‾\overline{\mathbf{x}}连续,如果x‾\overline{\mathbf{x}}是非线性规划问题的局部最优解,则

下降方向集∩G0=∅\text{下降方向集} \cap G_0 = \varnothing

已经是局部最优解,自然没有可以继续下降的方向

Fritz John条件

设

  • x‾∈S\overline{\mathbf{x}} \in S
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • f,gi(i∈I)f,g_i (i \in I)在x‾\overline{\mathbf{x}}处可微
  • gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处连续

如果x‾\overline{\mathbf{x}}是非线性规划问题的局部最优解,则存在不全为0的非负数w0,wi(i∈I)w_0, w_i(i \in I),使得

w0∇f(x‾)−∑i∈Iwi∇gi(x‾)=0w_0\nabla f(\overline{\mathbf{x}}) - \sum_{i \in I}w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}

证明:根据上面下降方向集∩G0=∅\text{下降方向集} \cap G_0 = \varnothing,即不等式

{∇f(x‾)Td<0−∇gi(x‾)Td<0,i∈I\begin{cases} \nabla f(\overline{\mathbf{x}})^T\mathbf{d} < 0 \\ -\nabla g_i(\overline{\mathbf{x}})^T \mathbf{d} < 0, \quad i \in I \end{cases}

无解,再由超平面分离定理(两个凸集分离,直观地看是指两个凸集合没有交叉和重合的部分,因此可以用一张超平面将两者隔在两边),必存在非零向量

w=(w0,wi,i∈I)≥0\mathbf{w} = (w_0, w_i, i \in I) \geq \mathbf{0}

使得

w∇f(x‾)−∑i∈Iwi∇gi(x‾)=0w \nabla f(\overline{\mathbf{x}}) - \sum_{i \in I} w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}

在使用Fritz John条件时,可能出现w0=0w_0 = 0的情况,这时候Fritz John条件中不包含目标函数的任何数据,只是把起作用的约束的梯度组合成了零向量。这样的解的描述没有价值,我们需要w0≠0w_0 \neq 0的情况,为了保证这样,我们需要添加某种限制,这样的限制称为约束规格,在定理Fritz John条件中,如果增加起作用约束的梯度线性无关的约束规格,则给出不等式约束问题的K-T条件

Kuhn-Tucker条件

考虑非线性规划问题,设

  • x‾∈S\overline{\mathbf{x}} \in S
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • f,gi(i∈I)f,g_i (i \in I)在x‾\overline{\mathbf{x}}处可微
  • gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处连续
  • {∇gi(x‾)∣i∈I}\color{blue}\lbrace \nabla g_i(\overline{\mathbf{x}}) | i \in I \rbrace线性无关

如果x‾\overline{\mathbf{x}}是非线性规划问题的局部最优解,则存在非负数wi,i∈Iw_i, i \in I,使得

∇f(x‾)−∑i∈Imwi∇gi(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I} w_i \nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}

证明:

根据Fritz John条件,有

w0∇f(x‾)−∑i∈Imwi∇gi(x‾)=0w_0 \nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I} w_i\nabla g_i(\overline{\mathbf{x}}) = 0

w0w_0不能为0,如果为0,则会导致{∇gi(x‾)∣i∈I}\lbrace \nabla g_i(\overline{\mathbf{x}}) | i \in I \rbrace线性相关,于是可以使

wi=wi^w0,i∈Iw_i = \frac{\hat{w_i}}{w_0}, \quad i \in I

从而得到

{∇f(x‾)−∑i∈Imwi∇gi(x‾)=0wi≥0,i∈I\begin{cases} \nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I}w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0} \\ w_i \geq 0, \quad i \in I \end{cases}

若gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处可微,则K-T条件可写成等价形式:

{∇f(x‾)−∑i=1mwi∇gi(x‾)=0wigi(x‾)=0,i=1,⋯ ,mwi≥0,i=1,⋯ ,m\begin{cases} \nabla f(\overline{\mathbf{x}}) - \sum^m_{i=1}w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0} \\ w_ig_i(\overline{\mathbf{x}}) = 0, \quad i = 1,\cdots,m \\ w_i \geq 0, \quad i = 1,\cdots,m \end{cases}

  • 当i∉Ii \notin I时,gi(x‾)≠0g_i(\overline{\mathbf{x}}) \neq 0,由上面的条件可以知道wi=0w_i = 0,这时,项wigi(x‾)w_ig_i(\overline{\mathbf{x}})自然消去,得到上面的等式。
  • 当i∈Ii \in I时,gi(x‾)=0g_i(\overline{\mathbf{x}}) = \mathbf{0},因此条件wigi(x‾)=0w_ig_i(\overline{\mathbf{x}}) = 0对wiw_i没有限制

条件wigi(x‾)w_ig_i(\overline{\mathbf{x}})称为互补松弛条件

  • ∇f(x‾)−∑i=1mwi∇gi(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum^m_{i=1}w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}含有m+nm + n个未知量及m+nm + n个方程的方程组
  • 如果给定点x‾\overline{\mathbf{x}},验证它是否为K-T点,只需要解方程组∇f(x‾)−∑i∈Iwi∇gi(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum_{i \in I} w_i \nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}
  • 如果x‾\overline{\mathbf{x}}没有给定,欲求问题的K-T点,就需要解上述的等价形式的方程

∇f(x‾)−∑i=1mwi∇gi(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum^m_{i=1}w_i\nabla g_i(\overline{\mathbf{x}}) = \mathbf{0}实质是在x‾\overline{\mathbf{x}}时,ff的梯度方向等于g\mathbf{g}的方向


对于凸优化,也有最优解的一阶充分条件
定理:在非线性规划问题中,设

  • ff是凸函数
  • gi(i=1,⋯ ,m)g_i(i = 1,\cdots,m)是凹函数
  • SS为可行域,x‾∈S\overline{\mathbf{x}} \in S
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • f,gi(i∈I)f,g_i (i \in I)在x‾\overline{\mathbf{x}}处可微
  • gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处连续
  • 在x‾\overline{\mathbf{x}}处K-T条件成立

则x‾\overline{\mathbf{x}}为全局最优解

凸函数的局部最优解为全局最优解

一般约束问题的一阶最优性条件

记

g(x)=(g1(x)g2(x)⋮gm(x)),h(x)=(h1(x)h2(x)⋮hl(x))\mathbf{g}(\mathbf{x}) = \begin{pmatrix} g_1(\mathbf{x}) \\ g_2(\mathbf{x}) \\ \vdots \\ g_m(\mathbf{x}) \end{pmatrix}, \quad \mathbf{h}(\mathbf{x}) = \begin{pmatrix} h_1(\mathbf{x}) \\ h_2(\mathbf{x}) \\ \vdots \\ h_l(\mathbf{x}) \end{pmatrix}

将非线性规划问题写作

minf(x),x∈Rns.t.g(x)≥0s.t.h(x)=0\begin{aligned} min &\qquad f(\mathbf{x}), \mathbf{x} \in \mathbb{R}^n \\ s.t. &\qquad \mathbf{g}(\mathbf{x}) \geq \mathbf{0} \\ s.t. &\qquad \mathbf{h}(\mathbf{x}) = \mathbf{0} \end{aligned}

正则点

定义:设x‾\mathbf{\overline{x}}为可行点,不等式约束中在x‾\mathbf{\overline{x}}起作用约束下标集记作II,如果向量组

{∇gi(x‾),∇hj(x‾)∣i∈I,j=1,2,⋯ ,l}\lbrace \nabla g_i(\overline{\mathbf{x}}), \nabla h_j(\overline{\mathbf{x}}) | i \in I, j = 1,2,\cdots,l \rbrace

线性无关,就称x‾\overline{\mathbf{x}}为约束g(x)≥0\mathbf{g}(\mathbf{x}) \geq \mathbf{0}和h(x)=0\mathbf{h}(\mathbf{x}) = \mathbf{0}的正则点

切平面

点集{x=x(t)∣t0≤t≤t1}\lbrace \mathbf{x} = \mathbf{x}(t) | t_0 \leq t \leq t_1 \rbrace称为曲面S={x∣h(x)=0}S = \lbrace \mathbf{x} | \mathbf{h}(\mathbf{x}) = \mathbf{0} \rbrace上的一条曲线,如果对所有t∈[t0,t1]t \in [t_0, t_1]均有

h(x(t))=0\mathbf{h}(\mathbf{x}(t)) = \mathbf{0}

显然,曲线上的点是参数tt的函数,如果导数x′(t)=dx(t)dt\mathbf{x}'(t) = \frac{d\mathbf{x(t)}}{dt}存在,则称曲线是可微的

  • 曲线x(t)\mathbf{x}(t)的一阶导数x′(t)\mathbf{x}'(t)是曲线在点x(t)\mathbf{x}(t)处的切向量
  • 曲面SS上在点x\mathbf{x}处所有可微曲线的切向量组成的集合,称为曲面SS在点x\mathbf{x}的切平面,记作T(x)T(\mathbf{x})

为了表达切平面,定义下列子空间

H={d∣∇h(x)Td=0}H = \lbrace \mathbf{d} | \nabla \mathbf{h}(\mathbf{x})^T\mathbf{d} = \mathbf{0} \rbrace

其中∇h(x)=(∇h1(x),∇h2(x),⋯ ,∇h1(x))\nabla \mathbf{h}(\mathbf{x}) = (\nabla h_1(\mathbf{x}) , \nabla h_2(\mathbf{x}), \cdots, \nabla h_1(\mathbf{x})),∇hj(x)\nabla h_j(\mathbf{x})是hj(x)h_j(\mathbf{x})的梯度
根据切平面TT及子空间HH的定义,在点x‾\overline{\mathbf{x}},若向量d∈T(x‾)\mathbf{d} \in T(\overline{\mathbf{x}}),则有

d∈H=def{d∣∇h(x‾)Td=0}\mathbf{d} \in H \xlongequal{def} \lbrace \mathbf{d} | \nabla \mathbf{h}(\overline{\mathbf{x}})^T\mathbf{d} = \mathbf{0} \rbrace

反之不一定成立,但若x‾\overline{\mathbf{x}}是约束h(x)=0\mathbf{h}(\mathbf{x}) = \mathbf{0}的正则点,反之也成立

定理:设x‾\overline{\mathbf{x}}是曲面S={x∣h(x)=0}S = \lbrace \mathbf{x} | \mathbf{h}(\mathbf{x}) = \mathbf{0} \rbrace上一个正则点(即∇hi(x‾)\nabla h_i(\overline{\mathbf{x}})线性无关),则在点x‾\overline{\mathbf{x}}的切平面T(x‾)T(\overline{\mathbf{x}})等于子空间H={d∣∇h(x‾)Td=0}H = \lbrace \mathbf{d} | \nabla \mathbf{h}(\overline{\mathbf{x}})^T\mathbf{d} = \mathbf{0} \rbrace

Fritz John条件丨最优解的一阶必要条件

定理:设在约束极值问题中

  • x‾\overline{\mathbf{x}}为可行点
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • f,gi(i∈I)f,g_i (i \in I)在x‾\overline{\mathbf{x}}处可微
  • gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处连续
  • 且∇hi(x‾)∣i=1,2,⋯ ,l}\nabla h_i(\overline{\mathbf{x}}) | i = 1,2,\cdots,l \rbrace线性无关

如果x‾\overline{\mathbf{x}}是非线性规划问题的局部最优解,则在x‾\overline{\mathbf{x}}处,有

下降方向集∩G0∩切平面=∅\text{下降方向集} \cap G_0 \cap \text{切平面} = \varnothing

已经是局部最优解,自然没有可以继续下降的方向

如果x‾\overline{\mathbf{x}}是局部最优解,则存在不全为0的w0,wi(i∈I)w_0,w_i(i \in I)和vj(j=1,⋯ ,j)v_j(j=1,\cdots,j),使得

w0∇f(x‾)−∑i∈Iwi∇gi(x‾)−∑j=1lvj∇hj(x‾)=0,w0,wi≥0,i∈Iw_0 \nabla f(\overline{\mathbf{x}}) - \sum_{i \in I}w_i \nabla g_i(\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}, \quad w_0,w_i \geq 0, \quad i \in I

证明:

如果∇hi(x‾)\nabla h_i(\overline{\mathbf{x}})线性相关,则存在不全为0的数,使得∑j=1lvj∇hj(x‾)=0\sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0},令w0,wi=0w_0,w_i=0即可得出答案。

如果线性无关,由下降方向集∩G0∩切平面=∅\text{下降方向集} \cap G_0 \cap \text{切平面} = \varnothing,即不等式组

{∇f(x‾)Td<0−∇gi(x‾)Td<0,i∈I∇hj(x‾)Td=0,j=1,⋯ ,l\begin{cases} \nabla f(\overline{\mathbf{x}})^T\mathbf{d} < 0 \\ -\nabla g_i(\overline{\mathbf{x}})^T \mathbf{d} < 0, \quad i \in I \\ \nabla h_j(\overline{\mathbf{x}})^T \mathbf{d} = 0, \quad j =1,\cdots,l \end{cases}

无解

  • 令AA是以∇f(x‾)T,−∇gi(x‾)T\nabla f(\overline{\mathbf{x}})^T, -\nabla g_i(\overline{\mathbf{x}})^T为行组成的矩阵
  • 令BB是以−hj(x‾)T-h_j(\overline{\mathbf{x}})^T为组成的矩阵

上述不等式组化为

{Ad<0Bd=0\begin{cases} A\mathbf{d} < \mathbf{0} \\ B\mathbf{d} = \mathbf{0} \end{cases}

非空凸集的分离定理:设S1S_1和S2S_2是Rn\mathbb{R}^n中两个非空凸集,S1∩S2=∅S_1 \cap S_2 = \varnothing,则存在非零向量p\mathbf{p},使得

inf⁡{pTx∣x∈S1}≥sup⁡{pTx∣x inS2}\inf \lbrace \mathbf{p}^T\mathbf{x} | \mathbf{x} \in S_1 \rbrace \geq \sup \lbrace \mathbf{p}^T\mathbf{x} | \mathbf{x} \ in S_2 \rbrace

定义两个集合

S1={[y1y2]∣y1=Ady2=Bd,d∈Rn}S2={[y1y2]∣y1<0y2=0}\begin{aligned} S_1 &= \lbrace \begin{bmatrix} \mathbf{y}_1 \\ \mathbf{y}_2 \end{bmatrix} | \begin{matrix} \mathbf{y}_1 = A\mathbf{d} \\ \mathbf{y}_2 = B\mathbf{d} \end{matrix}, \mathbf{d} \in \mathbb{R}^n\rbrace \\ S_2 &= \lbrace \begin{bmatrix} \mathbf{y}_1 \\ \mathbf{y}_2 \end{bmatrix} | \begin{matrix} \mathbf{y}_1 < \mathbf{0} \\ \mathbf{y}_2 = \mathbf{0} \end{matrix}\rbrace \end{aligned}

它们都是非空凸集,并且

S1∩S2=∅S_1 \cap S_2 = \varnothing

根据非空凸集的分离定理,存在非零向量

p=[p1p2]\mathbf{p} = \begin{bmatrix} \mathbf{p}_1 \\ \mathbf{p}_2 \end{bmatrix}

使得对任意d∈Rn\mathbf{d} \in \mathbb{R}^n及每一个点[y1y2]∈clS2\begin{bmatrix}\mathbf{y}_1\\\mathbf{y}_2\end{bmatrix} \in \text{cl} S_2成立

p1TAd+p2TBd≥p1Ty1+p2Ty2\mathbf{p}^T_1 A\mathbf{d} + \mathbf{p}^T_2 B\mathbf{d} \geq \mathbf{p}^T_1 \mathbf{y}_1 + \mathbf{p}^T_2\mathbf{y}_2

因为令y2=0\mathbf{y}_2 = \mathbf{0},且y1\mathbf{y}_1的每个分量可为任意负数,因此p1≥0\mathbf{p}_1 \geq \mathbf{0},在令

[y1y2]=[00]∈clS2\begin{bmatrix} \mathbf{y}_1 \\ \mathbf{y}_2 \end{bmatrix} = \begin{bmatrix} \mathbf{0} \\ \mathbf{0} \end{bmatrix} \in \text{cl} S_2

则又可得出

p1TAd+p2TBd≥0\mathbf{p}^T_1 A\mathbf{d} + \mathbf{p}^T_2 B\mathbf{d} \geq 0

因为d∈Rn\mathbf{d} \in \mathbb{R}^n,令d=−(ATp1+BTp2)\mathbf{d} = -(A^T\mathbf{p}_1 + B^T\mathbf{p}_2),带入后得到

−∥ATp1+BTp2∥2≥0- \parallel A^T\mathbf{p}_1 + B^T\mathbf{p}_2 \parallel^2 \geq 0

于是得到

ATp1+BTp2=0A^T\mathbf{p}_1 + B^T\mathbf{p}_2 = \mathbf{0}

  • 将p1\mathbf{p}_1的分量记作w0w_0和wi(i∈I)w_i(i \in I)
  • 将p2\mathbf{p}_2的分量记作vj(j=1,⋯ ,l)v_j(j = 1,\cdots,l)

则上式变为

w0∇f(x‾)−∑i∈Iwi∇gi(x‾)−∑j=1lvj∇hj(x‾)=0,w0,wi≥0,i∈Iw_0 \nabla f(\overline{\mathbf{x}}) - \sum_{i \in I}w_i \nabla g_i(\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}, \quad w_0,w_i \geq 0, \quad i \in I

同理,为了保证w0w_0不为零,需要非约束条件加上某种限制,即为K−TK-T必要条件

Kuhn-Tucker条件丨最优解的一阶必要条件

设在非线性规划问题

  • x‾\overline{\mathbf{x}}为可行点
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • f,gi(i∈I)f,g_i (i \in I)在x‾\overline{\mathbf{x}}处可微
  • gi(i∉I)g_i (i \notin I)在x‾\overline{\mathbf{x}}处连续
  • 且∇gi,∇hi(x‾)∣i=1,2,⋯ ,l}\nabla g_i, \nabla h_i(\overline{\mathbf{x}}) | i = 1,2,\cdots,l \rbrace线性无关

如果x‾\overline{\mathbf{x}}是非线性规划问题的局部最优解,则存在wi,i∈Iw_i, i \in I,使得

∇f(x‾)−∑i∈Iwi∇gi(x‾)−∑j=1lvj∇hj(x‾)=0,wi≥0,i∈I\nabla f(\overline{\mathbf{x}}) - \sum_{i \in I} w_i \nabla g_i(\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}, w_i \geq 0, i \in I

证明:

根据Fritz John条件,有不全为00的w0,w‾i(i∈I)w_0, \overline{w}_i(i \in I)和v‾j(j=1,⋯ ,l)\overline{v}_j(j=1,\cdots,l),使得

w0∇f(x‾)−∑i∈Iwi∇gi(x‾)−∑j=1lv‾j∇hj(x‾)=0,w0,w‾i≥0,i∈Iw_0 \nabla f(\overline{\mathbf{x}}) - \sum_{i \in I} w_i\nabla g_i(\overline{\mathbf{x}}) - \sum^l_{j = 1}\overline{v}_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}, \quad w_0,\overline{w}_i \geq 0,\quad i \in I

由向量组∇gi,∇hi(x‾)∣i=1,2,⋯ ,l}\nabla g_i, \nabla h_i(\overline{\mathbf{x}}) | i = 1,2,\cdots,l \rbrace线性无关,比得出w0≠0w_0 \neq 0,若不然会导致线性相关,令

wi=w‾iw0,i∈Ivj=v‾jw0,j=1,⋯ ,l\begin{aligned} w_i &= \frac{\overline{w}_i}{w_0}, & i \in I \\ v_j &= \frac{\overline{v}_j}{w_0}, & j = 1,\cdots,l \end{aligned}

带入化简后得到

∇f(x‾)−∑i∈Im∇gi(x‾)−∑j=1lvj∇hj(x‾)=0,wi≥0,i∈I\nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I}\nabla g_i (\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}, \quad w_i \geq 0, \quad i \in I

与不等式约束的情形类似,当gi(i∉I)g_i(i \notin I)在点x‾\overline{\mathbf{x}}也可微时,令其相应的乘子wi=0w_i = 0,于是可将上述K-T条件转化为下列等价形式

{∇f(x‾)−∑i∈Im∇gi(x‾)−∑j=1lvj∇hj(x‾)=0wigi(x‾)=0,i=1,2,⋯ ,mwi≥0,i=1,2,⋯ ,m\begin{cases} \nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I}\nabla g_i (\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0} \\ w_i g_i(\overline{\mathbf{x}}) = 0, \quad i = 1,2,\cdots,m \\ w_i \geq 0, \quad i = 1,2,\cdots,m \end{cases}

其中wigi(x‾)=0w_i g_i(\overline{\mathbf{x}}) = 0仍被称为互补松弛条件

∇f(x‾)−∑i∈Im∇gi(x‾)−∑j=1lvj∇hj(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I}\nabla g_i (\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j \nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}实质是在x‾\overline{\mathbf{x}}时,ff的梯度方向等于g\mathbf{g}的梯度方向等于h\mathbf{h}的梯度方向

广义拉格朗日

定义广义的拉格朗日函数

L(x,w,v)=f(x)−∑i=1mwigi(x)−∑j=1lvihj(x)L(\mathbf{x}, \mathbf{w}, \mathbf{v}) = f(\mathbf{x}) - \sum^m_{i = 1}w_ig_i(\mathbf{x}) - \sum^l_{j = 1}v_ih_j(\mathbf{x})

在K-T条件下,若x‾\overline{\mathbf{x}}为非线性规划问题的局部最优解,则存在乘子向量w‾≥0\overline{\mathbf{w}} \geq 0和v‾\overline{\mathbf{v}},使得

∇xL(x‾,w‾,v‾)=0\nabla_x \mathbf{L}(\overline{\mathbf{x}}, \overline{\mathbf{w}}, \overline{\mathbf{v}}) = \mathbf{0}

这样,K-T乘子w‾\overline{\mathbf{w}}和v‾\overline{\mathbf{v}}也称为拉格朗日乘子,此时一般情形的一阶必要条件可以表达为

{∇x‾L(x‾,w‾,v‾)=0∇v‾L(x‾,w‾,v‾)=h(x‾)=0∇w‾L(x‾,w‾,v‾)=g(x‾)>0wigi(x‾)=0,i=1,⋯ ,mwi≥0,i=1,⋯ ,m\begin{cases} \nabla_{\overline{\mathbf{x}}} \mathbf{L}(\overline{\mathbf{x}}, \overline{\mathbf{w}}, \overline{\mathbf{v}}) = \mathbf{0} \\ \nabla_{\overline{\mathbf{v}}} \mathbf{L}(\overline{\mathbf{x}}, \overline{\mathbf{w}}, \overline{\mathbf{v}}) = \mathbf{h}(\overline{\mathbf{x}}) = \mathbf{0} \\ \nabla_{\overline{\mathbf{w}}} \mathbf{L}(\overline{\mathbf{x}}, \overline{\mathbf{w}}, \overline{\mathbf{v}}) = \mathbf{g}(\overline{\mathbf{x}}) > \mathbf{0} \\ w_ig_i(\overline{\mathbf{x}}) = 0, \quad i = 1,\cdots, m \\ w_i \geq 0, \quad i = 1,\cdots, m \end{cases}


对于凸优化,也有最优解的一阶充分条件
定理:在非线性规划问题中,设

  • ff是凸函数
  • gi(i=1,⋯ ,m)g_i(i = 1,\cdots,m)是凹函数
  • hj(j)=1,⋯ ,lh_j(j)= 1,\cdots,l是线性函数
  • SS为可行域,x‾∈S\overline{\mathbf{x}} \in S
  • I={i∣gi(x‾)=0}I = \lbrace i | g_i(\overline{\mathbf{x}}) = 0 \rbrace
  • 在x‾\overline{\mathbf{x}}处K-T条件成立

即存在wi≥0(i∈I)w_i \geq 0(i \in I)及vj(j=1,⋯ ,l)v_j(j = 1,\cdots,l),使得

∇f(x‾)−∑i∈Imwi∇gi(x‾)−∑j=1lvj∇hj(x‾)=0\nabla f(\overline{\mathbf{x}}) - \sum^m_{i \in I}w_i\nabla g_i(\overline{\mathbf{x}}) - \sum^l_{j = 1}v_j\nabla h_j(\overline{\mathbf{x}}) = \mathbf{0}

则x‾\overline{\mathbf{x}}为全局最优解

不是凸优化的话,K-T条件只是极小值点的必要条件,不是充分条件,K-T点是驻点,是可能的极值点。

K-T条件总结

问题 拉格朗日函数 K-T条件
minf(x)s.t.g(x)=0\begin{aligned}min &\qquad f(\mathbf{x})\\s.t. &\qquad \mathbf{g}(\mathbf{x}) = \mathbf{0}\end{aligned} L(x,λ)=f(x)−λg(x)L(\mathbf{x}, \mathbf{\lambda}) = f(\mathbf{x}) - \mathbf{\lambda} \mathbf{g}(\mathbf{x}) {∇x‾L(x‾,λ‾)=∇f(x‾)−λ‾∇g(x‾)=0∇λ‾L(x‾,λ‾)=g(x‾)=0\begin{cases}\nabla_{\overline{\mathbf{x}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \nabla f(\overline{\mathbf{x}}) - \overline{\mathbf{\lambda}} \nabla \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\nabla_{\overline{\mathbf{\lambda}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\end{cases}
minf(x)s.t.g(x)≥0\begin{aligned}min &\qquad f(\mathbf{x})\\s.t. &\qquad \mathbf{g}(\mathbf{x}) \geq \mathbf{0}\end{aligned} L(x,λ)=f(x)−λg(x)L(\mathbf{x}, \mathbf{\lambda}) = f(\mathbf{x}) - \mathbf{\lambda} \mathbf{g}(\mathbf{x}) {∇x‾L(x‾,λ‾)=∇f(x‾)−λ‾∇g(x‾)=0∇λ‾L(x‾,λ‾)=g(x‾)≥0λ‾g(x‾)=0λ‾≥0\begin{cases}\nabla_{\overline{\mathbf{x}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \nabla f(\overline{\mathbf{x}}) - \overline{\mathbf{\lambda}} \nabla \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\nabla_{\overline{\mathbf{\lambda}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \mathbf{g}(\overline{\mathbf{x}}) \geq \mathbf{0}\\\overline{\mathbf{\lambda}} \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \geq \mathbf{0}\end{cases}
minf(x)s.t.g(x)≤0\begin{aligned}min &\qquad f(\mathbf{x})\\s.t. &\qquad \mathbf{g}(\mathbf{x}) \leq \mathbf{0}\end{aligned} L(x,λ)=f(x)+λg(x)L(\mathbf{x}, \mathbf{\lambda}) = f(\mathbf{x}) + \mathbf{\lambda} \mathbf{g}(\mathbf{x}) {∇x‾L(x‾,λ‾)=∇f(x‾)+λ‾∇g(x‾)=0∇λ‾L(x‾,λ‾)=g(x‾)≤0λ‾g(x‾)=0λ‾≥0\begin{cases}\nabla_{\overline{\mathbf{x}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \nabla f(\overline{\mathbf{x}}) + \overline{\mathbf{\lambda}} \nabla \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\nabla_{\overline{\mathbf{\lambda}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}) = \mathbf{g}(\overline{\mathbf{x}}) \leq \mathbf{0}\\\overline{\mathbf{\lambda}} \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \geq \mathbf{0}\end{cases}
minf(x)s.t.g(x)≥0h(x)=0\begin{aligned}min &\qquad f(\mathbf{x})\\s.t. &\qquad \mathbf{g}(\mathbf{x}) \geq \mathbf{0}\\ &\qquad \mathbf{h}(\mathbf{x}) = \mathbf{0}\end{aligned} L(x,λ,μ)=f(x)−λg(x)−μh(x)L(\mathbf{x}, \mathbf{\lambda}, \mathbf{\mu}) = f(\mathbf{x}) - \mathbf{\lambda} \mathbf{g}(\mathbf{x}) - \mathbf{\mu} \mathbf{h}(\mathbf{x}) {∇x‾L(x‾,λ‾,μ‾)=∇f(x‾)−λ‾∇g(x‾)−μ‾∇h(x‾)=0∇λ‾L(x‾,λ‾,μ‾)=g(x‾)≥0∇μ‾L(x‾,λ‾,μ‾)=h(x‾)=0λ‾g(x‾)=0λ‾≥0\begin{cases}\nabla_{\overline{\mathbf{x}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \nabla f(\overline{\mathbf{x}}) - \overline{\mathbf{\lambda}} \nabla \mathbf{g}(\overline{\mathbf{x}}) - \overline{\mathbf{\mu}} \nabla \mathbf{h}(\overline{\mathbf{x}}) = \mathbf{0}\\\nabla_{\overline{\mathbf{\lambda}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \mathbf{g}(\overline{\mathbf{x}}) \geq \mathbf{0}\\\nabla_{\overline{\mathbf{\mu}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \mathbf{h}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \geq \mathbf{0}\end{cases}
minf(x)s.t.g(x)≤0h(x)=0\begin{aligned}min &\qquad f(\mathbf{x})\\s.t. &\qquad \mathbf{g}(\mathbf{x}) \leq \mathbf{0}\\ &\qquad \mathbf{h}(\mathbf{x}) = \mathbf{0}\end{aligned} L(x,λ,μ)=f(x)+λg(x)−μh(x)L(\mathbf{x}, \mathbf{\lambda}, \mathbf{\mu}) = f(\mathbf{x}) + \mathbf{\lambda} \mathbf{g}(\mathbf{x}) - \mathbf{\mu} \mathbf{h}(\mathbf{x}) {∇x‾L(x‾,λ‾,μ‾)=∇f(x‾)+λ‾∇g(x‾)−μ‾∇h(x‾)=0∇λ‾L(x‾,λ‾,μ‾)=g(x‾)≤0∇μ‾L(x‾,λ‾,μ‾)=h(x‾)=0λ‾g(x‾)=0λ‾≥0\begin{cases}\nabla_{\overline{\mathbf{x}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \nabla f(\overline{\mathbf{x}}) + \overline{\mathbf{\lambda}} \nabla \mathbf{g}(\overline{\mathbf{x}}) - \overline{\mathbf{\mu}} \nabla \mathbf{h}(\overline{\mathbf{x}}) = \mathbf{0}\\\nabla_{\overline{\mathbf{\lambda}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \mathbf{g}(\overline{\mathbf{x}}) \leq \mathbf{0}\\\nabla_{\overline{\mathbf{\mu}}} L(\overline{\mathbf{x}}, \overline{\mathbf{\lambda}}, \overline{\mathbf{\mu}}) = \mathbf{h}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \mathbf{g}(\overline{\mathbf{x}}) = \mathbf{0}\\\overline{\mathbf{\lambda}} \geq \mathbf{0}\end{cases}

参考文献