[概率论] - 随机变量的数字特征

数学期望

离散型随机变量

设离散型随机变量X的分布律为

P(X=xk)=pkk=1,2,⋯P(X=x_k)=p_k \quad k=1, 2, \cdots

若级数

∑k=1∞xkpk\sum_{k=1}^\infty x_kp_k

绝对收敛,则称级数∑k=1∞xkpk\sum_{k=1}^\infty x_kp_k为随机变量XX的数学期望,记为E(X)E(X)

连续型随机变量

设连续型随机变量的概率密度函数为

f(x)f(x)

若积分

∫−∞∞xf(x)dx\int_{-\infty}^\infty xf(x)dx

绝对收敛,则称积分∫∞∞xf(x)dx\int_\infty^\infty xf(x)dx为随机变量XX的数学期望,记为E(X)E(X)

数学期望的性质

  • E(c)=cE(c) = c
  • E(cX)=cE(X)E(cX) = cE(X)
  • E(X+Y)=E(X)+E(Y)E(X+Y)=E(X)+E(Y)
  • E(XY)=E(X)E(Y)X,Y相互独立E(XY)=E(X)E(Y) \quad X,Y\text{相互独立}
  • 设YY是随机变量XX的函数Y=g(X)Y=g(X)(gg是连续函数),则有
    • XX是离散型:E(Y)=E(g(X))=∑k=1∞g(xk)pkE(Y) = E(g(X)) = \sum^\infty_{k=1}g(x_k)p_k
    • XX是连续型:E(Y)=E(g(X))=∫∞∞g(x)f(x)dxE(Y) = E(g(X)) = \int^\infty_\infty g(x)f(x)dx

条件期望的性质

  • E[a∣Y]=aE[a|Y] = a
  • E[aX+bZ∣Y]=aE[X∣Y]+bE[Z∣Y]E[aX + bZ|Y] = aE[X|Y] + bE[Z|Y]
  • E[X∣Y]=E[X](独立)E[X|Y] = E[X](\text{独立})
  • E[E[X∣Y]]=E[X]E[E[X|Y]] = E[X]
  • E[Xg(Y)∣Y]=g(Y)E[X∣Y]E[Xg(Y)|Y] = g(Y)E[X|Y]
  • E[X∣Y,g(Y)]=E[X∣Y]E[X|Y,g(Y)] = E[X|Y]
  • E[E[X∣Y,Z]]=E[X∣Y]E[E[X|Y,Z]] = E[X|Y]

期待频数

期待度数=列的周边度数×行的周边度数全体的度数\text{期待度数} = \frac{\text{列的周边度数}\times \text{行的周边度数}}{\text{全体的度数}}

离差

定义:X−E(X)X - E(X)

方差

设XX是一个随机变量,若E((X−E(X))2)E((X - E(X))^2)存在,则称

D(X)=E((X−E(X))2)D(X) = E((X - E(X))^2)

为随机变量XX的方差,记为D(X)D(X)或Var(X)Var(X)

方差 - 离散型随机变量

D(X)=∑k=1∞[xk−E(X)]2pkD(X)=\sum_{k=1}^\infty[x_k - E(X)]^2 p_k

方差 - 连续型随机变量

D(X)=∫−∞∞[x−E(X)]2f(x)dxD(X)=∫_{-\infty}^\infty[x - E(X)]^2 f(x)dx

方差的性质

  • D(c)=0D(c) = 0
  • D(cX)=c2D(x)D(cX) = c^2D(x)
  • D(X)=E(X2)−E(X)2D(X) = E(X^2) - E(X)^2
  • D(X±Y)=D(X)+D(Y)±2Cov(X,Y)D(X \pm Y) = D(X) \color{red}+\color{black} D(Y) \pm 2Cov(X,Y)

方差是协方差的一种特殊情况,即变量与自身的协方差

条件方差的性质

  • Var[Y∣X]=E[Y−E[Y∣X]2∣X]Var[Y|X] = E[Y - E[Y|X]^2|X]
  • E[Var[Y∣X]]=E[E[Y2∣X]]−E[E[Y∣X]2]=E[Y2]−E[E[Y∣X]2]E[Var[Y|X]] = E[E[Y^2|X]] - E[E[Y|X]^2] = E[Y^2] - E[E[Y|X]^2]
  • Var[E[Y∣X]]=E[E[Y∣X]2]−E[E[Y∣X]]2=E[E[Y∣X]2]−E[Y]2Var[E[Y|X]] = E[E[Y|X]^2] - E[E[Y|X]]^2 = E[E[Y|X]^2] - E[Y]^2
  • E[Var[Y∣X]]+Var[E[Y∣X]]=E[Y2]−E[Y]2=Var[Y]E[Var[Y|X]] + Var[E[Y|X]] = E[Y^2] - E[Y]^2 = Var[Y]

标准差(均方差)

σ(X)=D(X)=1N∑i=1N(xi−μ)2\sigma(X) = \sqrt{D(X)} = \sqrt{\frac{1}{N}\sum^N_{i=1}(x_i - \mu)^2}

  • σ(X+c)=σ(X)\sigma(X + c) = \sigma(X)
  • σ(cX)=c⋅σ(X)\sigma(cX) = c \cdot \sigma(X)
  • σ(X+Y)=σ2(X)+σ2(Y)+2Cov(X,Y)\sigma(X + Y) = \sqrt{\sigma^2(X) + \sigma^2(Y) + 2Cov(X, Y)}

协方差

Cov(X,Y)=E[(X−E(X))(Y−E(Y))]=∑i=1n(Xi−X‾)(Yi−Y‾)n−1\begin{aligned} Cov(X,Y) &= E[(X-E(X))(Y-E(Y))] \\ &= \frac{\sum^n_{i=1}(X_i - \overline{X})(Y_i - \overline{Y})}{n-1} \end{aligned}

协方差的意义

  • Cov(X,Y)>0Cov(X,Y) > 0,正相关
  • Cov(X,Y)<0Cov(X,Y) < 0,负相关
  • Cov(X,Y)=0Cov(X,Y) = 0,不相关

协方差的计算

Cov(X,Y)=E[(X−E(X))(Y−E(Y))]=E(XY−XE(Y)−YE(X)+E(X)+E(Y))=E(XY)−E(X)E(Y)−E(Y)E(X)+E(X)E(Y)=E(XY)−E(X)E(Y)\begin{aligned} Cov(X,Y) &= E[(X-E(X))(Y-E(Y))] \\ &= E(XY-XE(Y)-YE(X)+E(X)+E(Y)) \\ &= E(XY)-E(X)E(Y)-E(Y)E(X)+E(X)E(Y) \\ &= E(XY)-E(X)E(Y) \end{aligned}

协方差的性质

  • Cov(aX,bY)=abCov(X,Y)Cov(aX, bY) = abCov(X,Y),a,ba,b是常数
  • Cov(X1+X2,Y)=Cov(X1,Y)+Cov(X2,Y)Cov(X_1 + X_2, Y) = Cov(X_1, Y) + Cov(X_2, Y)
  • Cov(X,X)=E(X2)−E(X)2=D(X)Cov(X, X) = E(X^2) - E(X)^2 = D(X)

相关系数

表示2个随机变量之间线性相关密切程度的特征数

ρXY=Cov(X,Y)D(X)D(Y)=∑i=1n(xi−x‾)(yi−y‾)∑i=1n(xi−x‾)2∑i=1n(yi−y‾)2\begin{aligned} \rho_{XY} &= \frac{Cov(X,Y)}{\sqrt{D(X)D(Y)}} \\ &= \frac{\sum^n_{i=1}(x_i - \overline{x})(y_i - \overline{y})}{\sqrt{\sum^n_{i=1}(x_i - \overline{x})^2}\sqrt{\sum^n_{i=1}(y_i - \overline{y})^2}} \end{aligned}

相关系数的意义

  • ρXY\rho_{XY}较大时,X,YX,Y的线性关系程度较好
  • ρXY\rho_{XY}较小时,X,YX,Y的线性关系程度较差
  • ρXY=1\rho_{XY} = 1,X,YX,Y为严格线性关系
  • ρXY=0\rho_{XY} = 0,X,YX,Y没有线性关系

相关系数的性质

  • ∣ρXY∣≤1|\rho_{XY}| \leq 1
  • ∣ρXY∣=1⇔P(Y=a+bX)=1|\rho_{XY}| = 1 \Leftrightarrow P(Y = a+ bX) = 1
  • ρXY=0→X,Y\rho_{XY} = 0 \rightarrow X,Y不相关(相互独立)

偏相关系数

在多要素构成的系统中,研究某一个要素对另外一个要素的影响或相关程度,把其他要素的影响视作常数,单独研究两个要素直接按的相互关系的密切程度,其数值即为偏相关系数

例:

  • 因素:x,y,zx, y, z
    • ρxy\rho_{xy}:x,yx,y相关系数
    • ρyz\rho_{yz}:y,zy,z相关系数
    • ρxz\rho_{xz}:x,zx,z相关系数
  • 求:除去zz影响的x,yx,y的偏相关系数ρxy⋅z\rho_{xy\cdot z}

ρxy⋅z=ρxy−ρxzryz1−rxz21−ryz2\rho_{xy\cdot z} = \frac{\rho_{xy} - \rho_{xz}r_{yz}}{\sqrt{1 - r^2_{xz}}\sqrt{1 - r^2_{yz}}}

其性质和相关系数一样

假设两个对同一因素的线性回归模型的残差分别为e1,e2e_1,e_2,则除去这一因素的相关系数(即偏相关系数)为两残差的相关系数

Spearman相关系数

ii xix_i yiy_i 转换 RixR^x_i RiyR^y_i
11 11 11 →\rightarrow 1.51.5 1.51.5
22 11 22 →\rightarrow 1.51.5 3.53.5
33 22 11 →\rightarrow 3.53.5 1.51.5
44 22 33 →\rightarrow 3.53.5 55
55 33 22 →\rightarrow 55 3.53.5
66 66 66 →\rightarrow 66 66

然后按照右边的数据计算相关系数即可,不容易收到离群值的影响
在没有相同位的情况下

r=1−6n(n2−1)∑i=1n(Rix−Riy)2r = 1 - \frac{6}{n(n^2 - 1)}\sum^n_{i=1}(R^x_i - R^y_i)^2

例子:

RixR^x_i RiyR^y_i (Rix−Riy)2(R^x_i - R^y_i)^2
11 33 44
22 11 11
33 22 11
44 55 11
55 44 11
66 77 11
77 66 11
88 88 00

r=1−68(82−1)×10=0.881r = 1 - \frac{6}{8(8^2 - 1)} \times 10 = 0.881

标准误差

样本均值的估计标准误差,简称**平均值标准误差**

SDx‾=σnSD_{\overline{x}} = \frac{\sigma}{\sqrt{n}}

但是通常σ\sigma未知,此时可以用样本的标准差ss来估计SDx‾SD_{\overline{x}}

SEx‾=snSE_{\overline{x}} = \frac{s}{\sqrt{n}}

  • SDx‾SD_{\overline{x}}:样本平均值的标准差
  • ss:样本的标准差
  • SEx‾SE_{\overline{x}}:样本平均值的标准误

如果随机变量服从正态分布,则9595%置信区间可以表示为

[x‾±(SEx‾×1.96)][\overline{x} \pm (SE_{\overline{x}} \times 1.96)]

变异系数

cv=σμc_v = \frac{\sigma}{\mu}

矩

X,YX,Y为一个随机变量,k=1,2,⋯k=1,2,\cdots

  • 若E(Xk)E(X^k)存在,则称之为XX的kk阶(原点)矩
  • 若E[(X−E(X))k]E[(X - E(X))^k]存在,则称之为XX的kk阶中心矩
  • 若E(XkYl)E(X^k Y^l)存在,则称之为XX与YY的k+lk+l阶混合(原点)矩
  • 若E[(X−E(X))k(Y−E(Y))l]E[(X - E(X))^k (Y - E(Y))^l]存在,则称之为XX与YY的kk阶混合中心矩

期望:11阶原点矩
方差:22阶中心矩

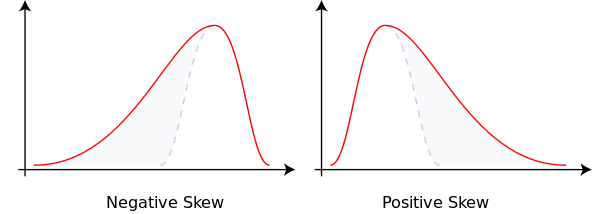
尖度

E[(X−μσ)3]E\Big[(\frac{X - \mu}{\sigma})^3\Big]

峰度

E[(X−μσ)4]E\Big[(\frac{X - \mu}{\sigma})^4\Big]

概率母函数

GX(t)=∑i=0∞P(X=i)ti=E(tX)∣t∣≤1G_X(t) = \sum^{\infty}_{i=0}P(X=i)t^i = E(t^X) \quad |t| \leq 1

一个离散随机变量的概率母函数是指该随机变量的概率质量函数的幂级数表达式。

GX(1)=1GX′(1)=E(X)G′′(1)+G′(1)(1−G′(1))=var(X)GX(0)=p0\begin{aligned} G_X(1) &= 1 \\ G_X'(1) &= E(X) \\ G''(1) + G'(1)(1 - G'(1)) &= var(X) \\ G_X(0) &= p_0 \end{aligned}

常见概率母函数

伯努利分布

GX(t)=q+ptG_X(t) = q + pt

几何分布

GX(t)=pt1−qt∣t∣<q−1G_X(t) = \frac{pt}{1 - qt} \quad |t| < q^{-1}

二项分布

GX(t)=(q+pt)n(q=1−p)G_X(t) = (q + pt)^n \quad (q = 1 - p)

泊松分布

GX(t)=∑k=0∞1k!λke−λtk=eλ(t−1)G_X(t) = \sum^{\infty}_{k=0}\frac{1}{k!}\lambda^ke^{-\lambda}t^k = e^{\lambda(t - 1)}

负二项分布

GX(t)=∑k=0∞(k−1n−1)pnqk−ntk=(pt1−qt)n∣t∣<q−1,p+q=1G_X(t) = \sum^{\infty}_{k=0}\begin{pmatrix} k - 1 \\ n - 1 \end{pmatrix}p^nq^{k-n}t^k = (\frac{pt}{1 - qt})^n \quad |t|< q^{-1}, p+q=1

唯一性定理

如果对于所有tt

GX(t)=GY(t)G_X(t) = G_Y(t)

则

P(X=k)=P(Y=k)P(X = k) = P(Y = k)

矩母函数

M(t)=∑n=0∞tnn!E[Xn]=E(etX)M(t) = \sum^{\infty}_{n=0}\frac{t^n}{n!}E[X^n] = E(e^{tX})

性质:00处的nn阶导数为XX的nn阶(原点)矩

E(Xn)=M(n)(0)E(X^n) = M^{(n)}(0)

与概率母函数关系

MX(log⁡(t))=E(etlog⁡(X))=E(Xt)=GX(t)M_X(\log(t)) = E(e^{t\log(X)}) = E(X^t) = G_X(t)

概率母函数和矩母函数都和分布一一对应

特征函数

特征函数

针对收敛半径为00的矩母函数的情况,好处是总是收敛。性质和矩母函数都差不多,就是有的地方多出了一个ii。

离散:ϕ(t)=∑n=0∞(it)nn!E[Xn]=M(it)=E(eitX)连续:∫eitXf(X)dX\begin{aligned} \text{离散}:& \phi(t) = \sum^{\infty}_{n=0}\frac{(it)^n}{n!}E[X^n] = M(it) = E(e^{itX}) \\ \text{连续}:& \int e^{itX} f(X)\mathrm{d}X \end{aligned}

特征函数是唯一确定分布的

设Z=X+YZ = X + Y,X,YX, Y相互独立,则

ϕZ(t)=E(eitZ)=E(eit(X+Y))=E(eitXeitY)=E(eitX)E(eitY)=ϕX(t)ϕY(t)\begin{aligned} \phi_Z(t) &= E(e^{itZ}) \\ &= E(e^{it(X + Y)}) \\ &= E(e^{itX}e^{itY}) \\ &= E(e^{itX})E(e^{itY}) \\ &= \phi_X(t)\phi_Y(t) \end{aligned}

一般的

ϕX1+X2+⋯+Xn(t)=ϕX1(t)ϕX2(t)⋯ϕXn(t)\phi_{X_1 + X_2 + \cdots + X_n}(t) = \phi_{X_1}(t)\phi_{X_2}(t)\cdots\phi_{X_n}(t)

  • 正态分布的峰度和尖度都为0

雅可比矩阵

多元函数在一个点的微分是一个局部线性变换,将该点的一个邻域映到一个开集,因此微分可以用矩阵的形式给出,每个列向量是偏导数,这个形式被称为雅可比矩阵

J=[∂f∂x1⋯∂f∂xn]=[∂f1∂x1⋯∂f1∂xn⋮⋱⋮∂fm∂x1⋯∂fm∂xn]J = \begin{bmatrix} \frac{\partial\mathbf{f}}{\partial x_1} & \cdots & \frac{\partial\mathbf{f}}{\partial x_n} \end{bmatrix} = \begin{bmatrix} \frac{\partial f_1}{\partial x_1} & \cdots & \frac{\partial f_1}{\partial x_n} \\ \vdots & \ddots & \vdots \\ \frac{\partial f_m}{\partial x_1} & \cdots & \frac{\partial f_m}{\partial x_n} \end{bmatrix}

雅可比矩阵Jf(p)J_f(p)就是函数ff在nn维空间某点pp处的导数

若Y=g(X)Y = g(X),则

fY(y)=fX(g−1(y))∣∣J∣∣f_Y(\mathbf{y}) = f_X(g^{-1}(\mathbf{y}))||J||

参考